claudeの週間制限17%減少! その効果的な対策の検証

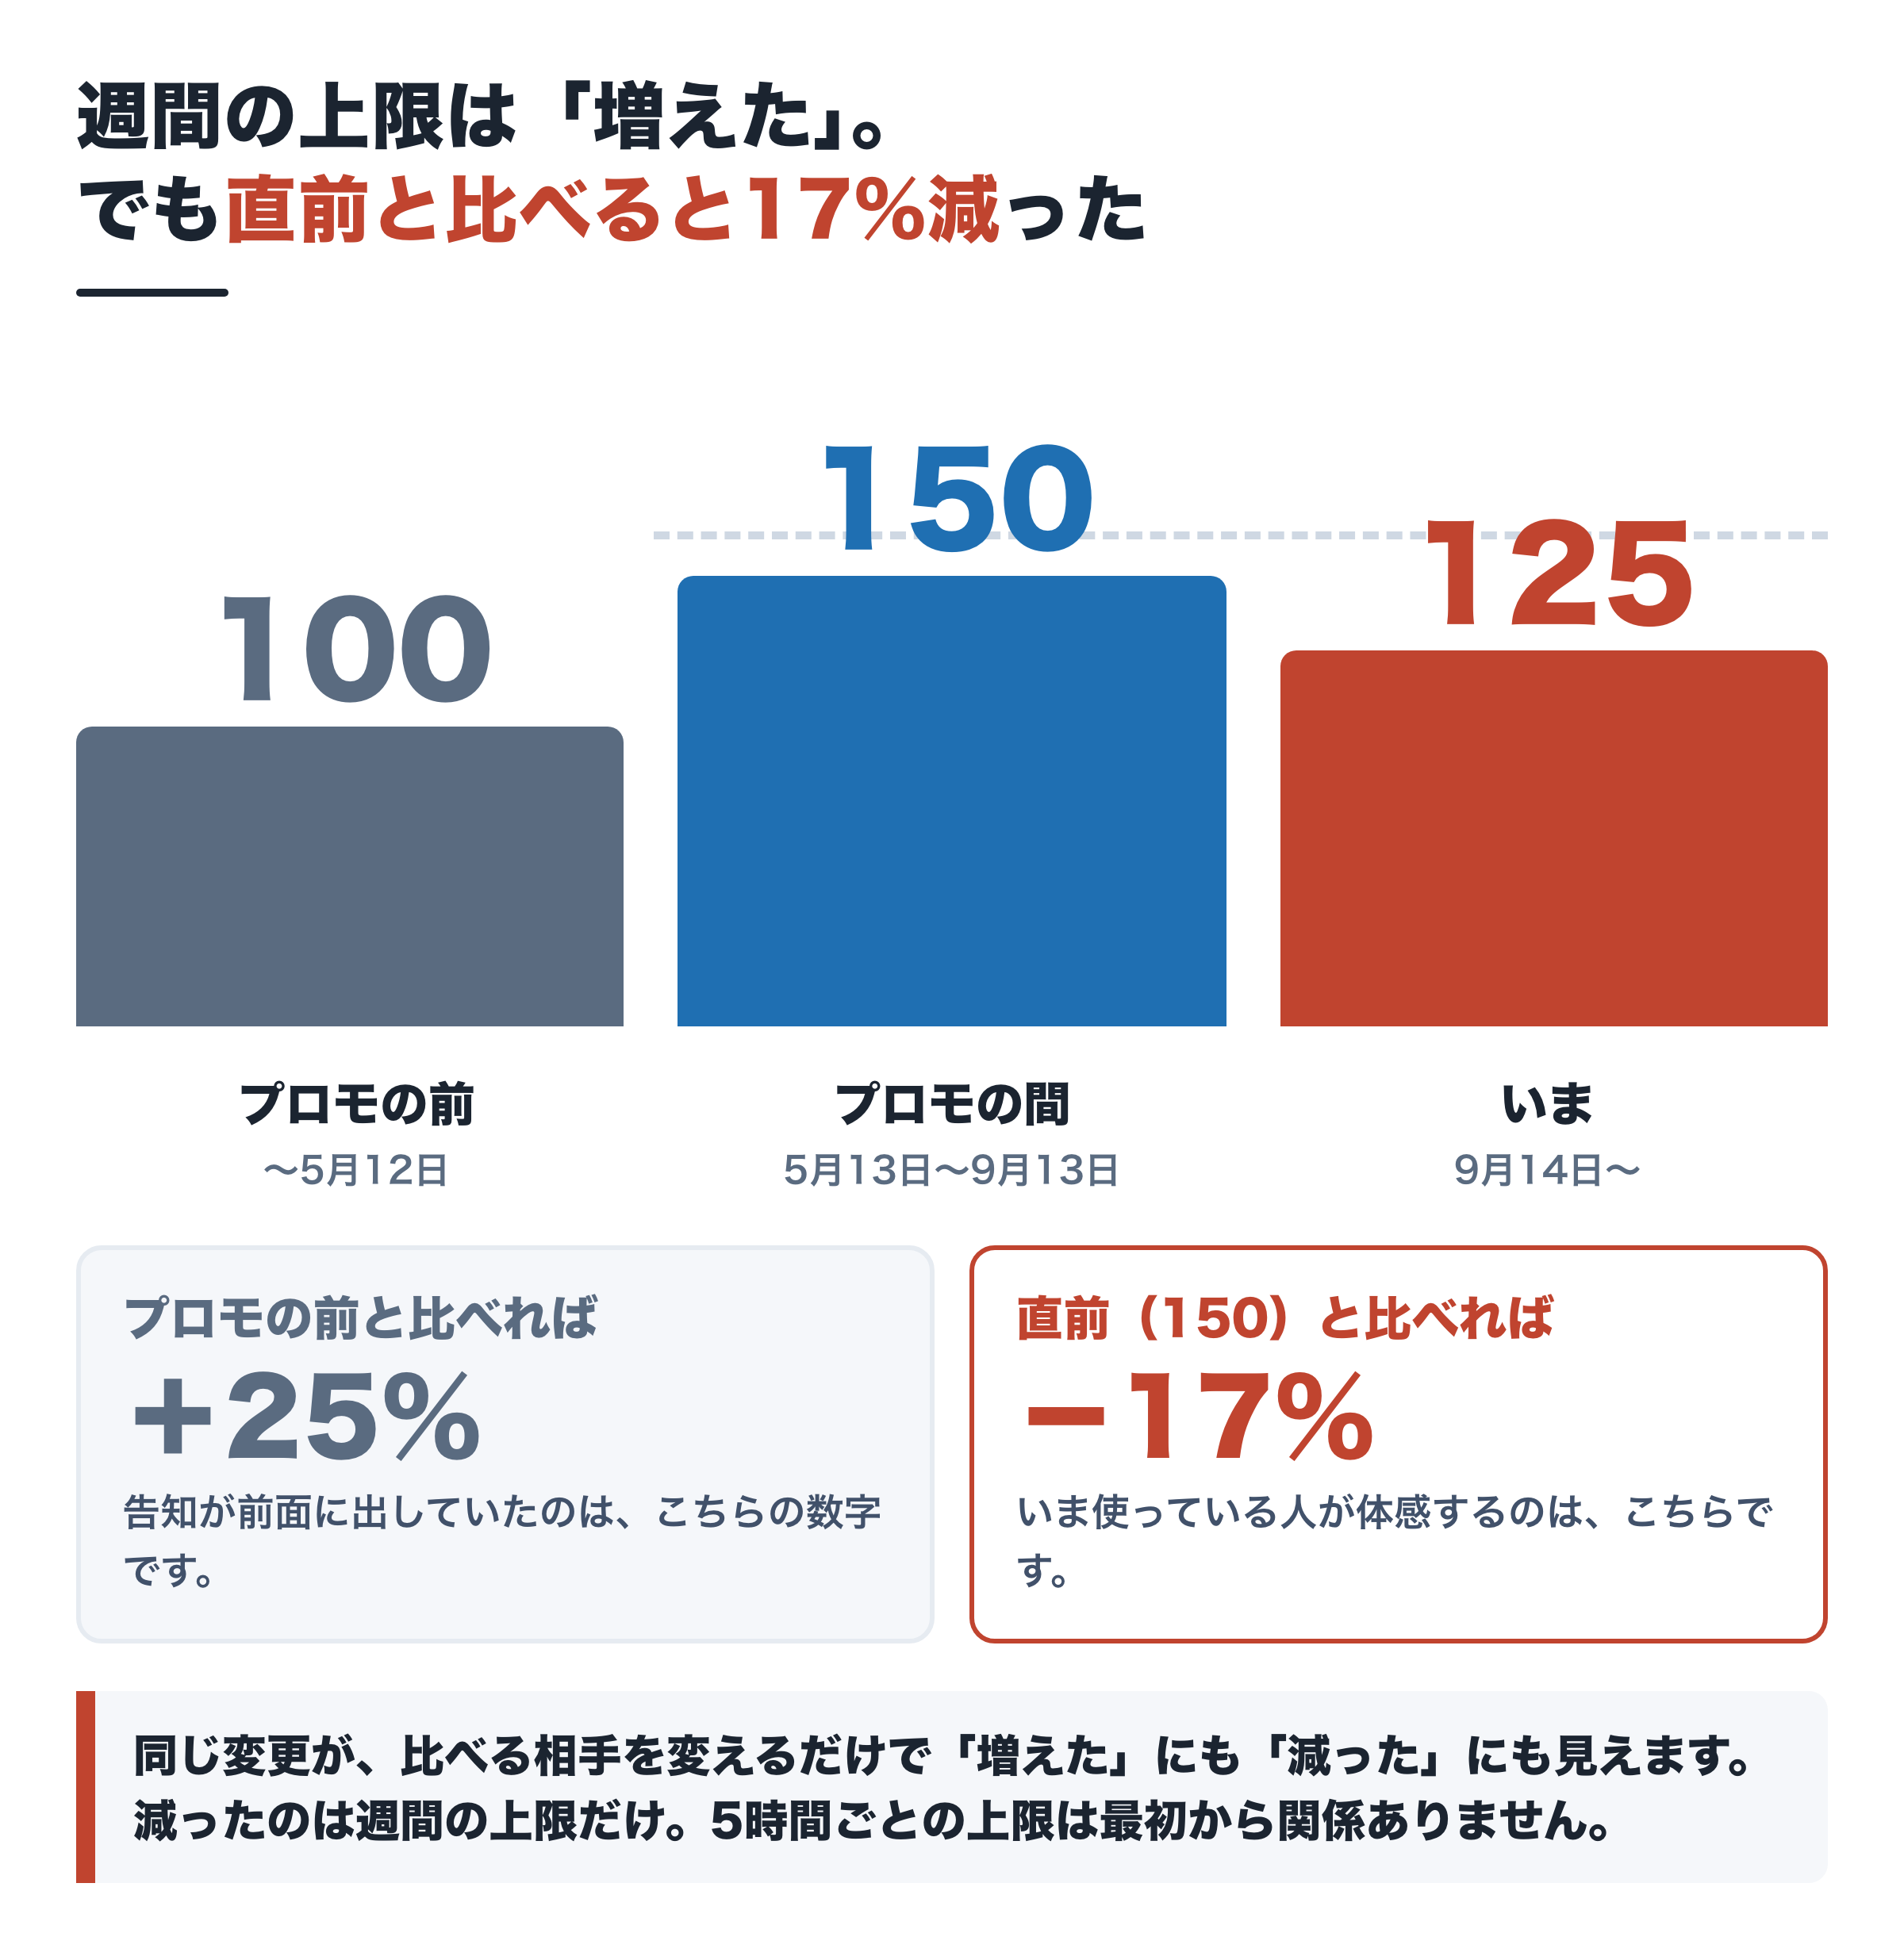
9月14日、Claude Codeの週間上限が17%下がりました。
ただでさえClaudeのコンテキスト制限は厳しい・・
それが悪化するなんてなんてひどい仕打ちだ・・
今回はそんな悩みに対して、実際の数字からコンテキストの節約のベストプラクティスを提案します。
一般論ではありません。
自分のログ45日分、156,013件を数えた結果です。
ただ、結論を先に言うと、私はこの調査の途中で一度つまずきました。
API料金表を使って「どう使えば安いか」を計算し、答えを出した。
でもその答えは、私が実際にぶつかっている壁とは、別の話でした。
物差しが2つあったのです。
その話をします。
今日の結論です。現時点で、私が測った限りの結論です。
間違っていたら、ぜひ教えてください。
Opusを本体にして、ここぞという判断のときだけFableを呼ぶ。
これが、定額プランでは一番長持ちする使い方でした。
なぜそうなるのかを、順に書きます。
第1章 何が減ったのか
Claude Codeには上限が2つあります。
ひとつは5時間ごとの上限。
もうひとつは週間の上限です。
前者が短距離走の制限で、後者が1週間分の総量の制限にあたります。
2026年5月13日から9月13日まで、Anthropicは「週間上限50%増」のキャンペーンをやっていました。
9月14日から、これが「恒久25%増」に変わりました。
プロモ前を100とすると、プロモ中が150、いまが125です。
プロモ前と比べれば25%増えています。
でも直前の150と比べれば、125は約17%減です。
この17%は私が計算した数字ではありません。
Anthropic自身が公式の開発者アカウントで認めています。
Compared to today, this works out to a 17% reduction in weekly limits on Claude Code.
最初の告知は「恒久25%増」だけを前面に出していました。
批判が集まり、投稿し直して17%減を明記しています。
ひとつだけ切り分けておきます。
プロモが増やしたのも、今回減ったのも、週間上限だけです。
5時間ごとの上限には最初から一切関係がありません。
(この記事は2026年9月時点の暫定です。自分の環境のログを45日分数えた範囲で言えることを書いています。まだ測っている途中で、次の測定で変わりうるところは、その都度そう書きます。)
第2章 私は3契約とも、毎週100%使い切っています
私は月220ドルのMaxプランを3つ契約しています。
個人事業主かつ法人経営者で、中小企業の支援とAIを使った実務の自動化が仕事です。
Claude Codeとは1日の大半を一緒に過ごしています。
そして3つとも、毎週きっちり使い切っています。
余らせたことがありません。
週の後半はいつも、残りを気にしながら仕事をしています。
この記事を書いている今この瞬間も、週間枠は84%まで来ています。
リセットまであと1日半。
そして今週も、たぶん使い切ります。
だから17%減は、私にとって他人事ではありません。
単純に、これまでできていた週の仕事のうち、17%ぶんができなくなるということです。
ここで正直に書くと、身構えたときに気づいたことがあります。
私は、自分が1週間に何をどれだけ使っているのかを、まったく知りませんでした。
毎週使い切っているのに、その中身を見たことがなかったのです。
節約術の一般論は世に多くあります。
「Sonnetを使え」「文脈を短く保て」「サブエージェントを使え」。
どれも理屈は通っています。
でも、自分の環境の数字で確かめたものは、ひとつもありませんでした。
だから数えることにしました。
第3章 自分の消費を掘り起こす
Claude Codeは、やったことを全部ログに残しています。
ホームフォルダの .claude/projects の下に、会話1本ごとにファイルが置かれます。
拡張子は .jsonl です。
そのファイルの中に、1回サーバーに問い合わせるたびに何トークン使ったかが記録されています。
このログを掘るやり方は、前にも書きました。
→ Fableであなたは損してます!モデル切り替えのベストプラクティスの実態実験
今回数えた対象は45日分。
会話3,181本、問い合わせ156,013件です。
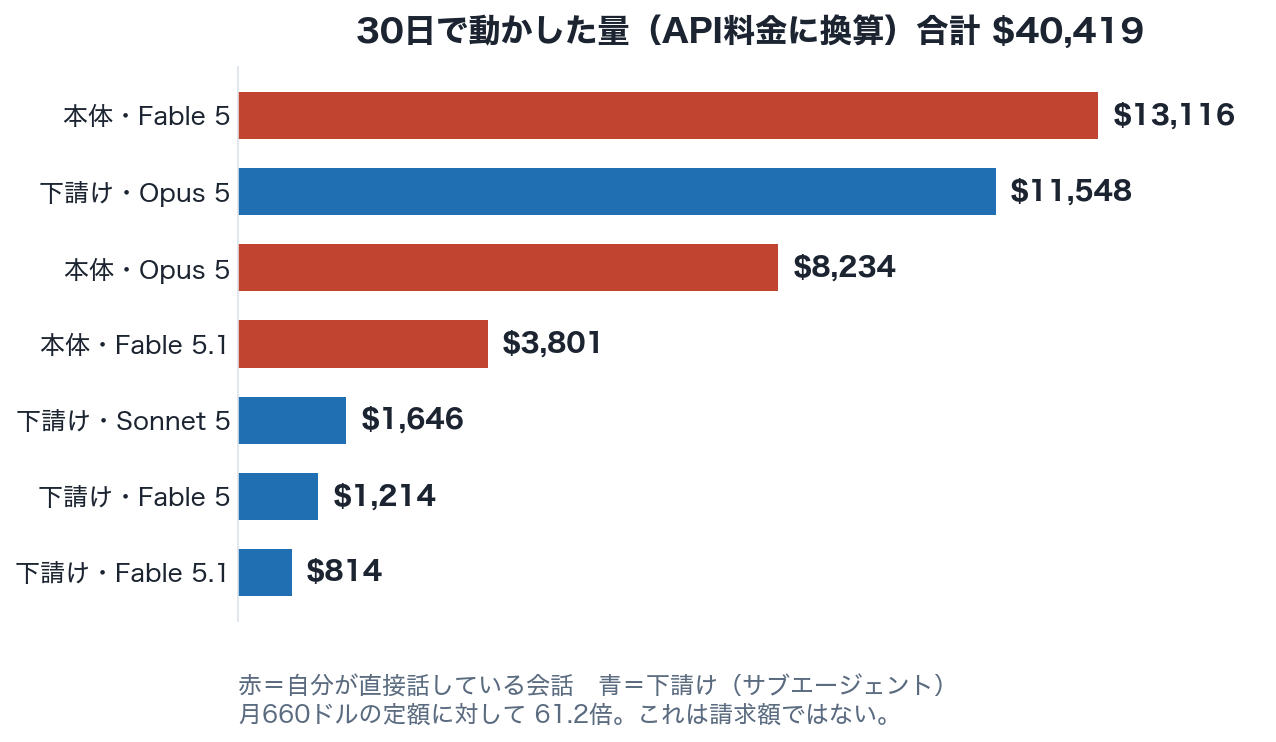
直近30日で私が動かした量は、API料金に換算すると40,419ドルでした。
月660ドルの定額に対して、61.2倍です。
つまりどういうことか。
私は定額プランなので、請求額は月660ドルのままです。
この40,419ドルは請求書には出てきません。
「定額の中で、これだけの量が動いていた」という話です。
上限がある理由が、この数字を見て腑に落ちました。
ただし、この金額は後で大事になります。
これは「API料金に換算するといくらか」であって、「私の週間枠をいくら食ったか」ではありません。
同じものだと思って読み進めた私は、あとで転びます。
数える前に信じていたこと
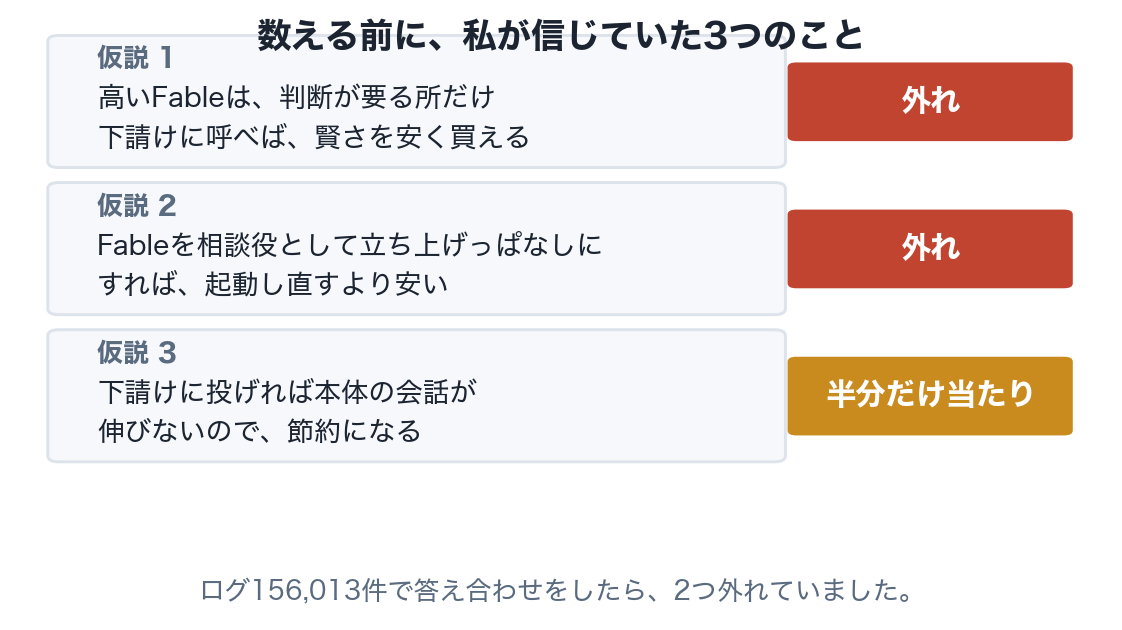
数える前の私は、この3つを正しいと思っていました。
仮説1。 高いFableは、判断が要るところだけ下請けに呼べばいい。
仮説2。 Fableは相談役として立ち上げっぱなしにしておけば、毎回起動し直すより安い。
仮説3。 下請けに投げれば本体の会話が伸びないので、節約になる。
言葉をひとつ決めておきます。
Claude Codeには「サブエージェント」という仕組みがあります。
本体が別に立ち上げる、使い捨てのAIです。
「これを調べて」と投げると、別の会話で調べて、要約だけを返してきます。
この記事では、これを「下請け」と呼びます。
そのほうが、何をしているか分かりやすいからです。
そして私が直接話している会話のほうを「本体」と呼びます。
第4章 消費を膨らませていたのは「書き直し」だった
まず、キャッシュという仕組みを噛み砕きます
ここが分かりにくいところなので、丁寧に書きます。
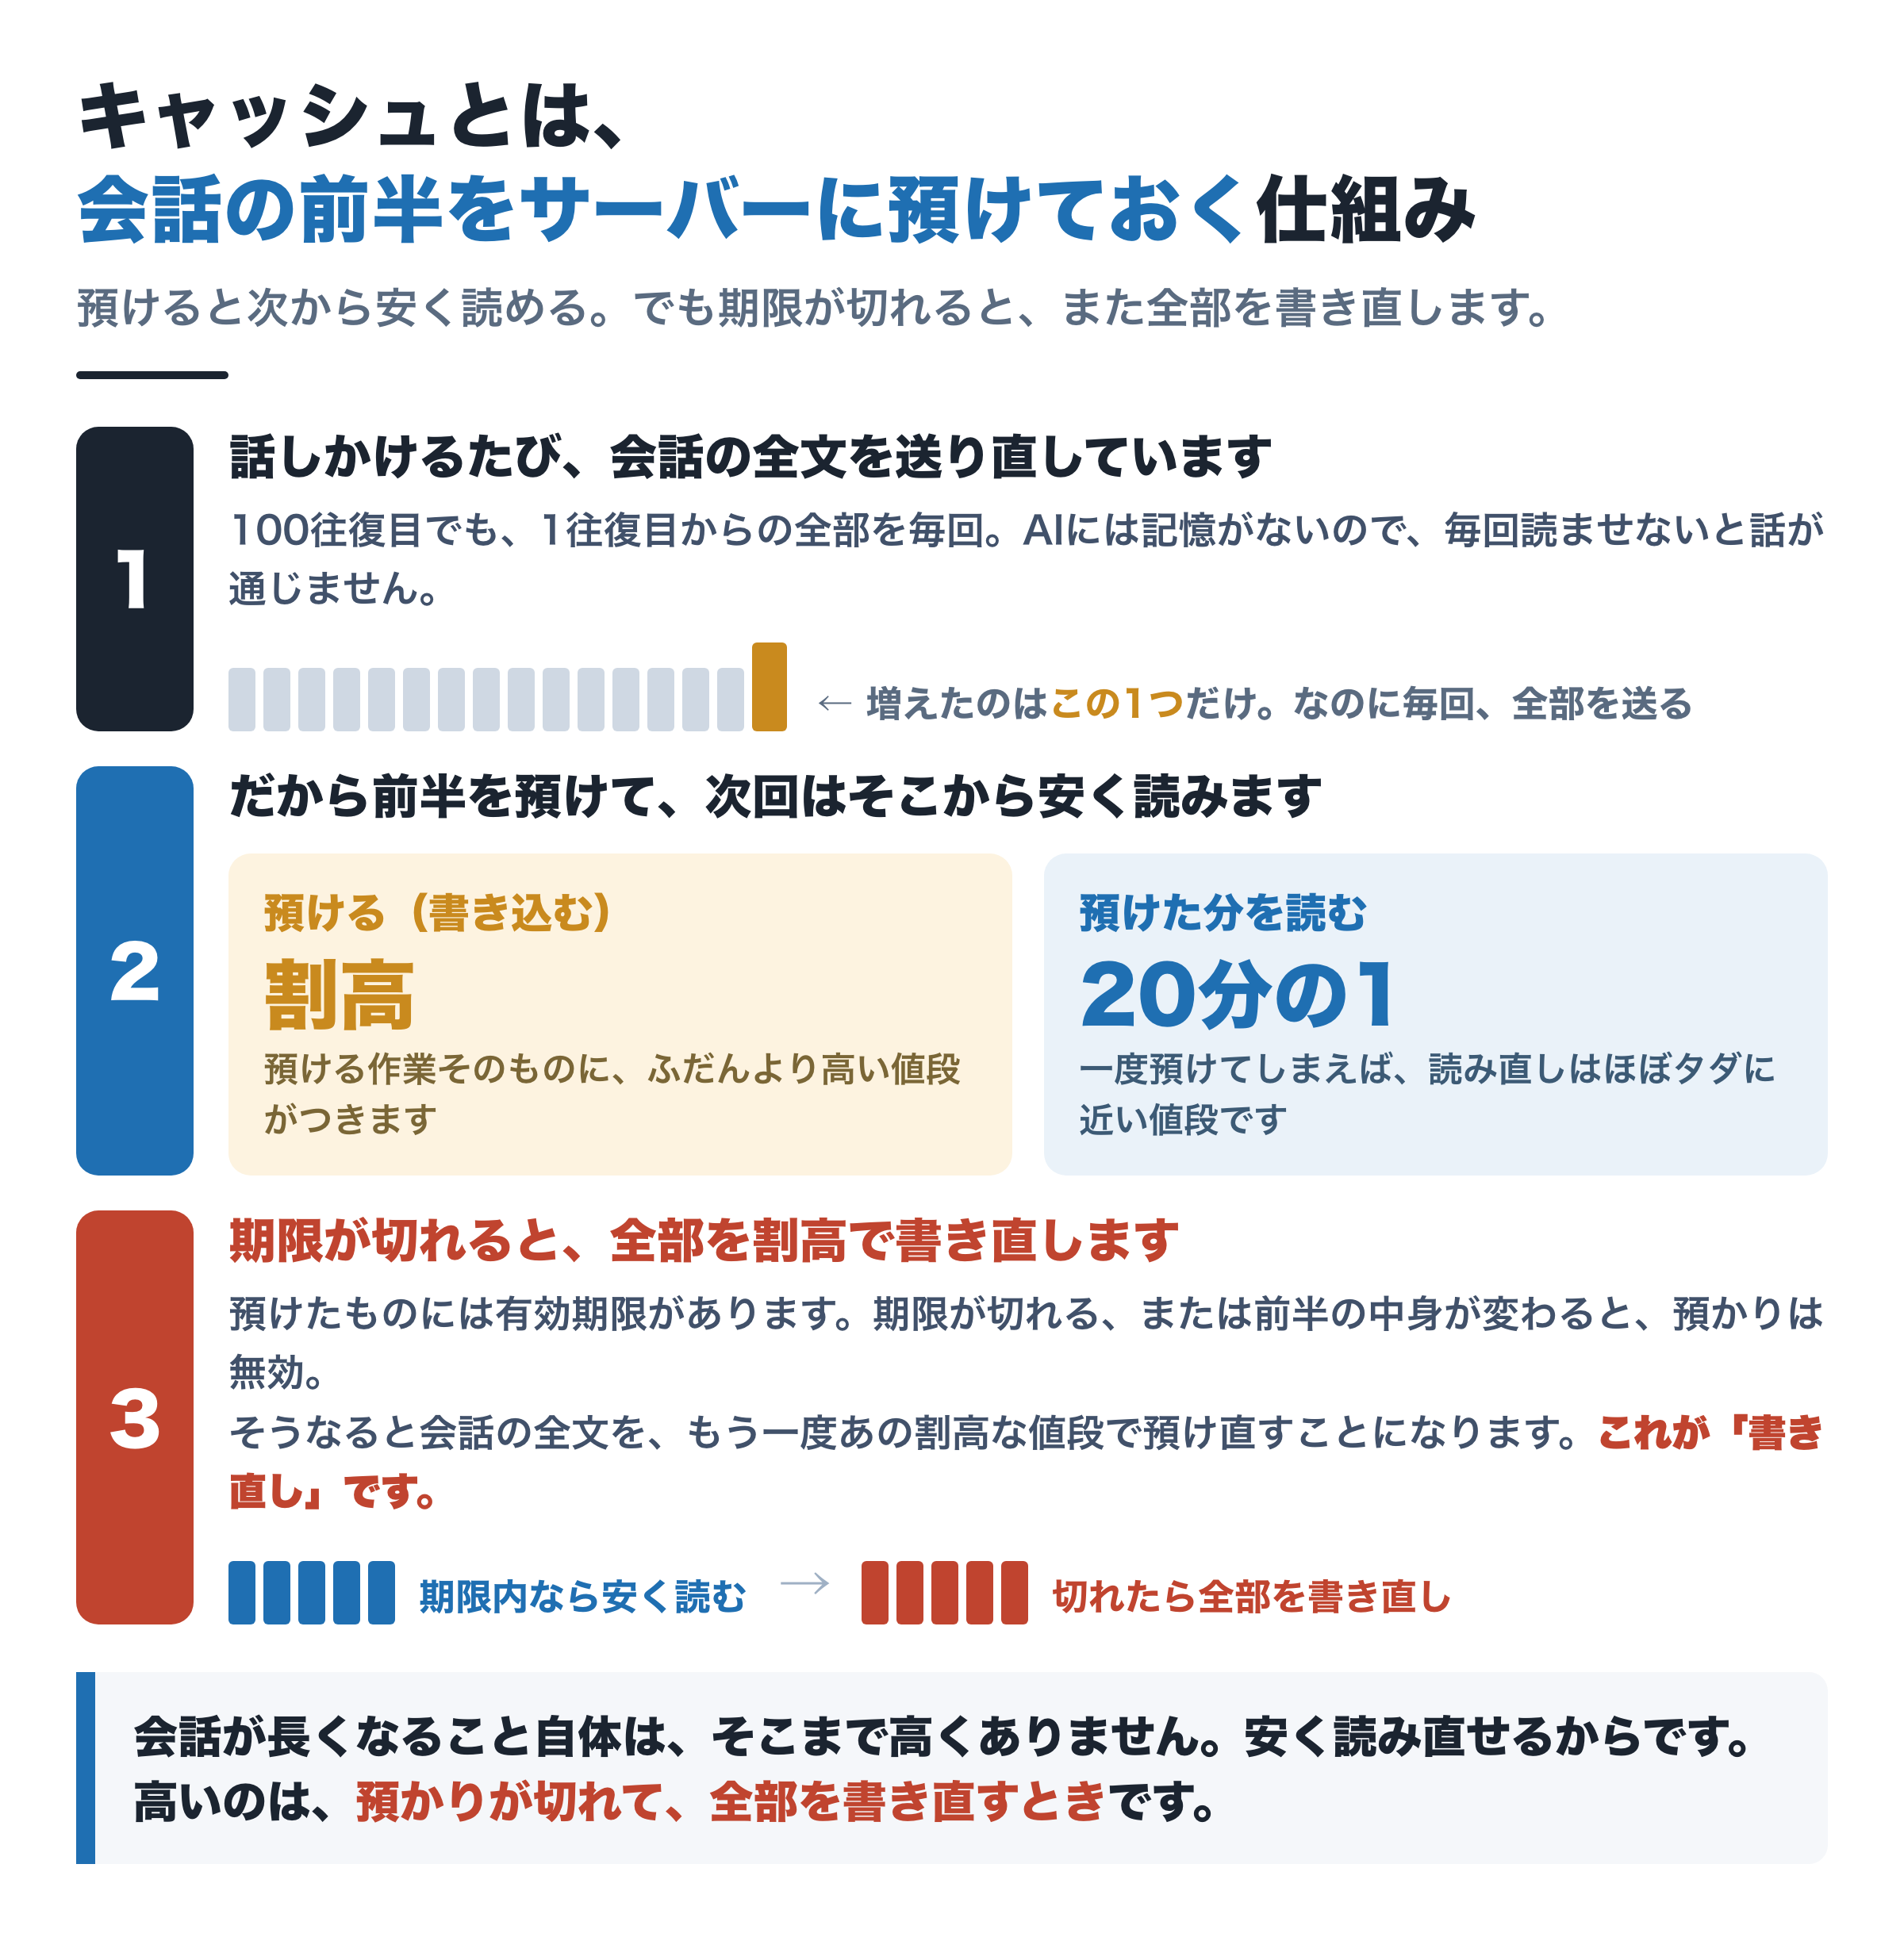
Claude Codeは、私が話しかけるたびに、会話の全文をサーバーに送り直しています。
100往復目の会話でも、1往復目からの全部を、毎回送っています。
AIには記憶がないので、毎回読ませないと話が通じないからです。
でも、同じ前半を毎回まるごと読み直すのは無駄です。
だからサーバー側に前半を一時保存しておいて、次回はそこから安く読む仕組みがあります。
これがキャッシュです。
- 保存に書き込むときは割高
- 保存から読むときは激安(書き込みの20分の1)
そして保存には有効期限があります。
期限が切れるか、前半の中身が変わると、保存は無効になります。
そうなると、全文をもう一度、割高な値段で書き込み直すことになります。
この記事では、これを「書き直し」と呼びます。
つまりどういうことか。
会話が長くなること自体は、そこまで高くありません。
安い値段で読み直せるからです。
高いのは、保存が切れて、全部を書き直すときです。
保存の期限は、本体と下請けで違いました
| 役 | 保存がもつ時間 | 実測 |
|---|---|---|
| 本体セッション | 1時間 | 書き込みの99.2%が1時間枠 |
| 下請け(サブエージェント) | 5分 | 書き込みの100.0%が5分枠 |
公式にこう書いてあります。
Subagents fall outside the main-conversation TTL bucket, so they get five minutes even on a subscription until you choose a longer one.
「サブエージェントはメイン会話の枠の外にあるので、定額プランでも5分になる」という意味です。
下請けは、5分ほったらかすと、それまでの会話の保存が全部切れます。
件数で見るのと、量で見るので、絵が反転する
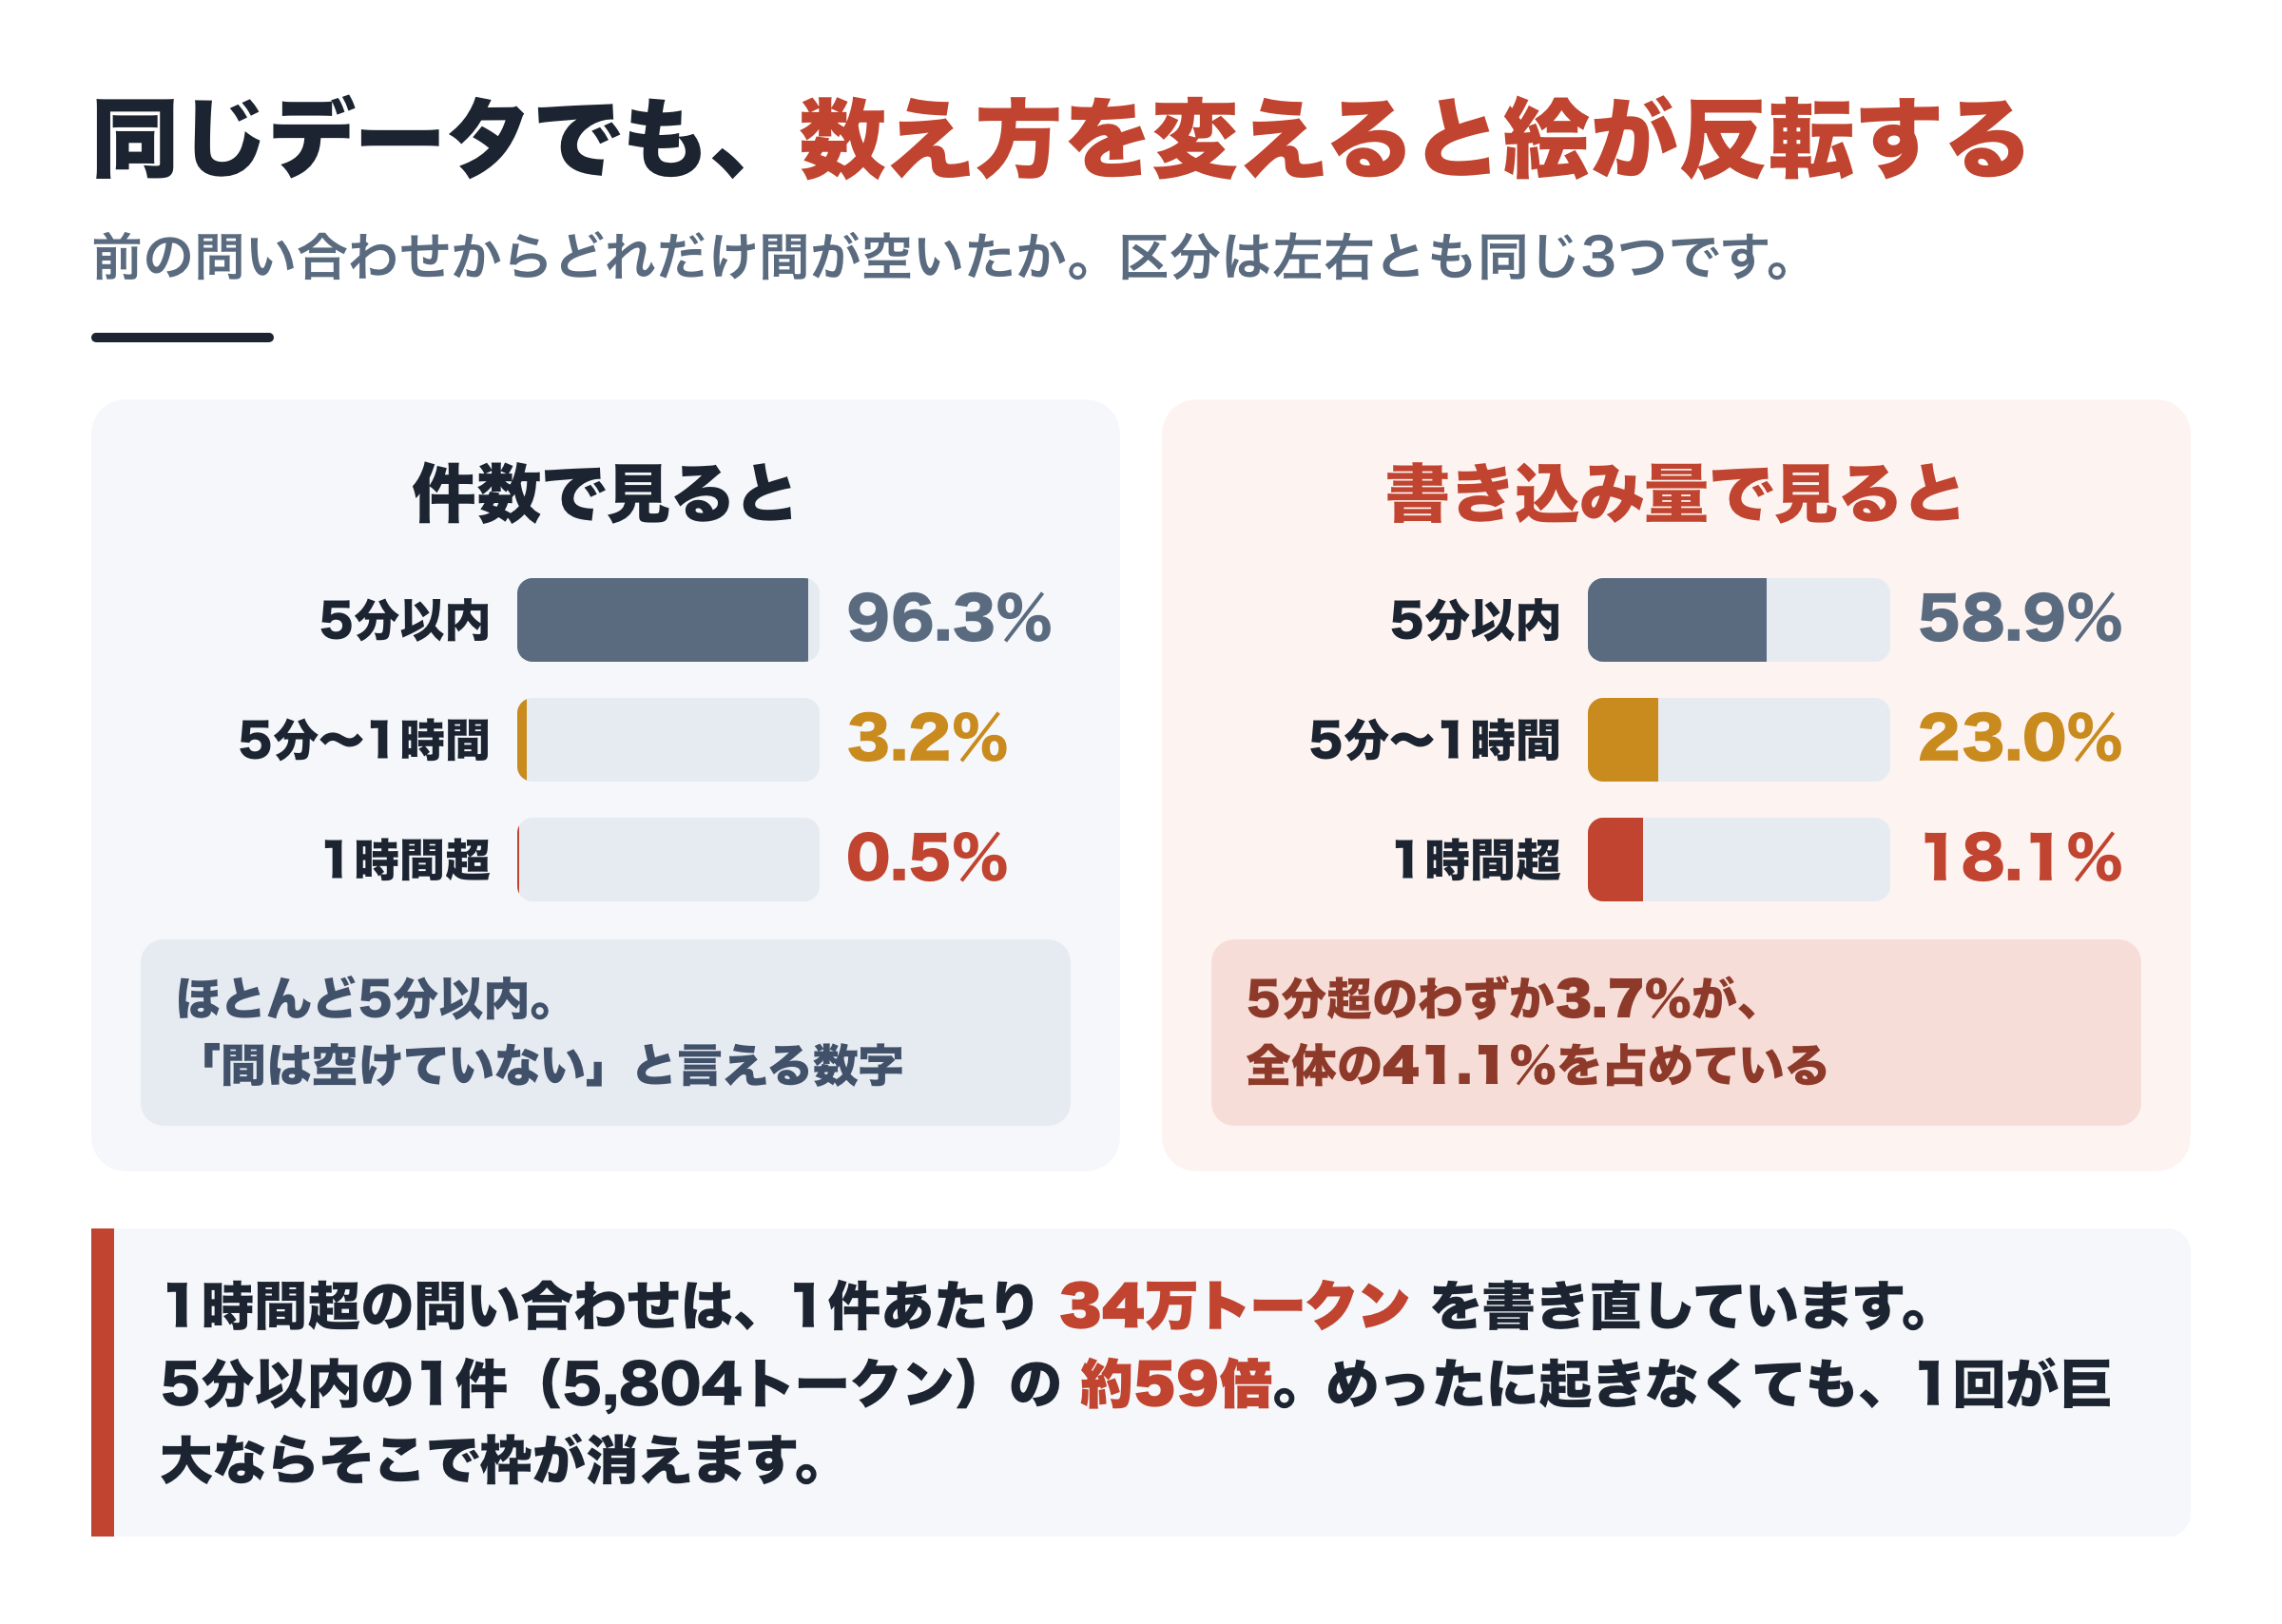
前の問い合わせからどれだけ時間が空いたかで、書き込み量がどう変わるかを数えました。
ここが今回いちばん驚いたところです。
件数で見ると、5分を超えて空いた問い合わせは全体の3.7%しかありません。
「私は間を空けていない、大丈夫だ」と言える数字です。
でも書き込み量で見ると、その3.7%が全体の41.1%を占めていました。
1時間超の問い合わせは、1件あたり34万トークンを書き直しています。
5分以内の1件が5,804トークンなので、約59倍です。
つまりどういうことか。
「めったに起きない」と「費用に効かない」は、まったく別でした。
たまにしか起きなくても、1回が巨大なら、そこで消えます。
第5章 サブエージェントには損益分岐点がある(ただしドルの話)
この章の数字は全部、API料金に換算した話です。
あとの第6章で、この前提がひっくり返ります。
それを承知の上で読んでください。
下請けは、呼んだ瞬間に前払いしている
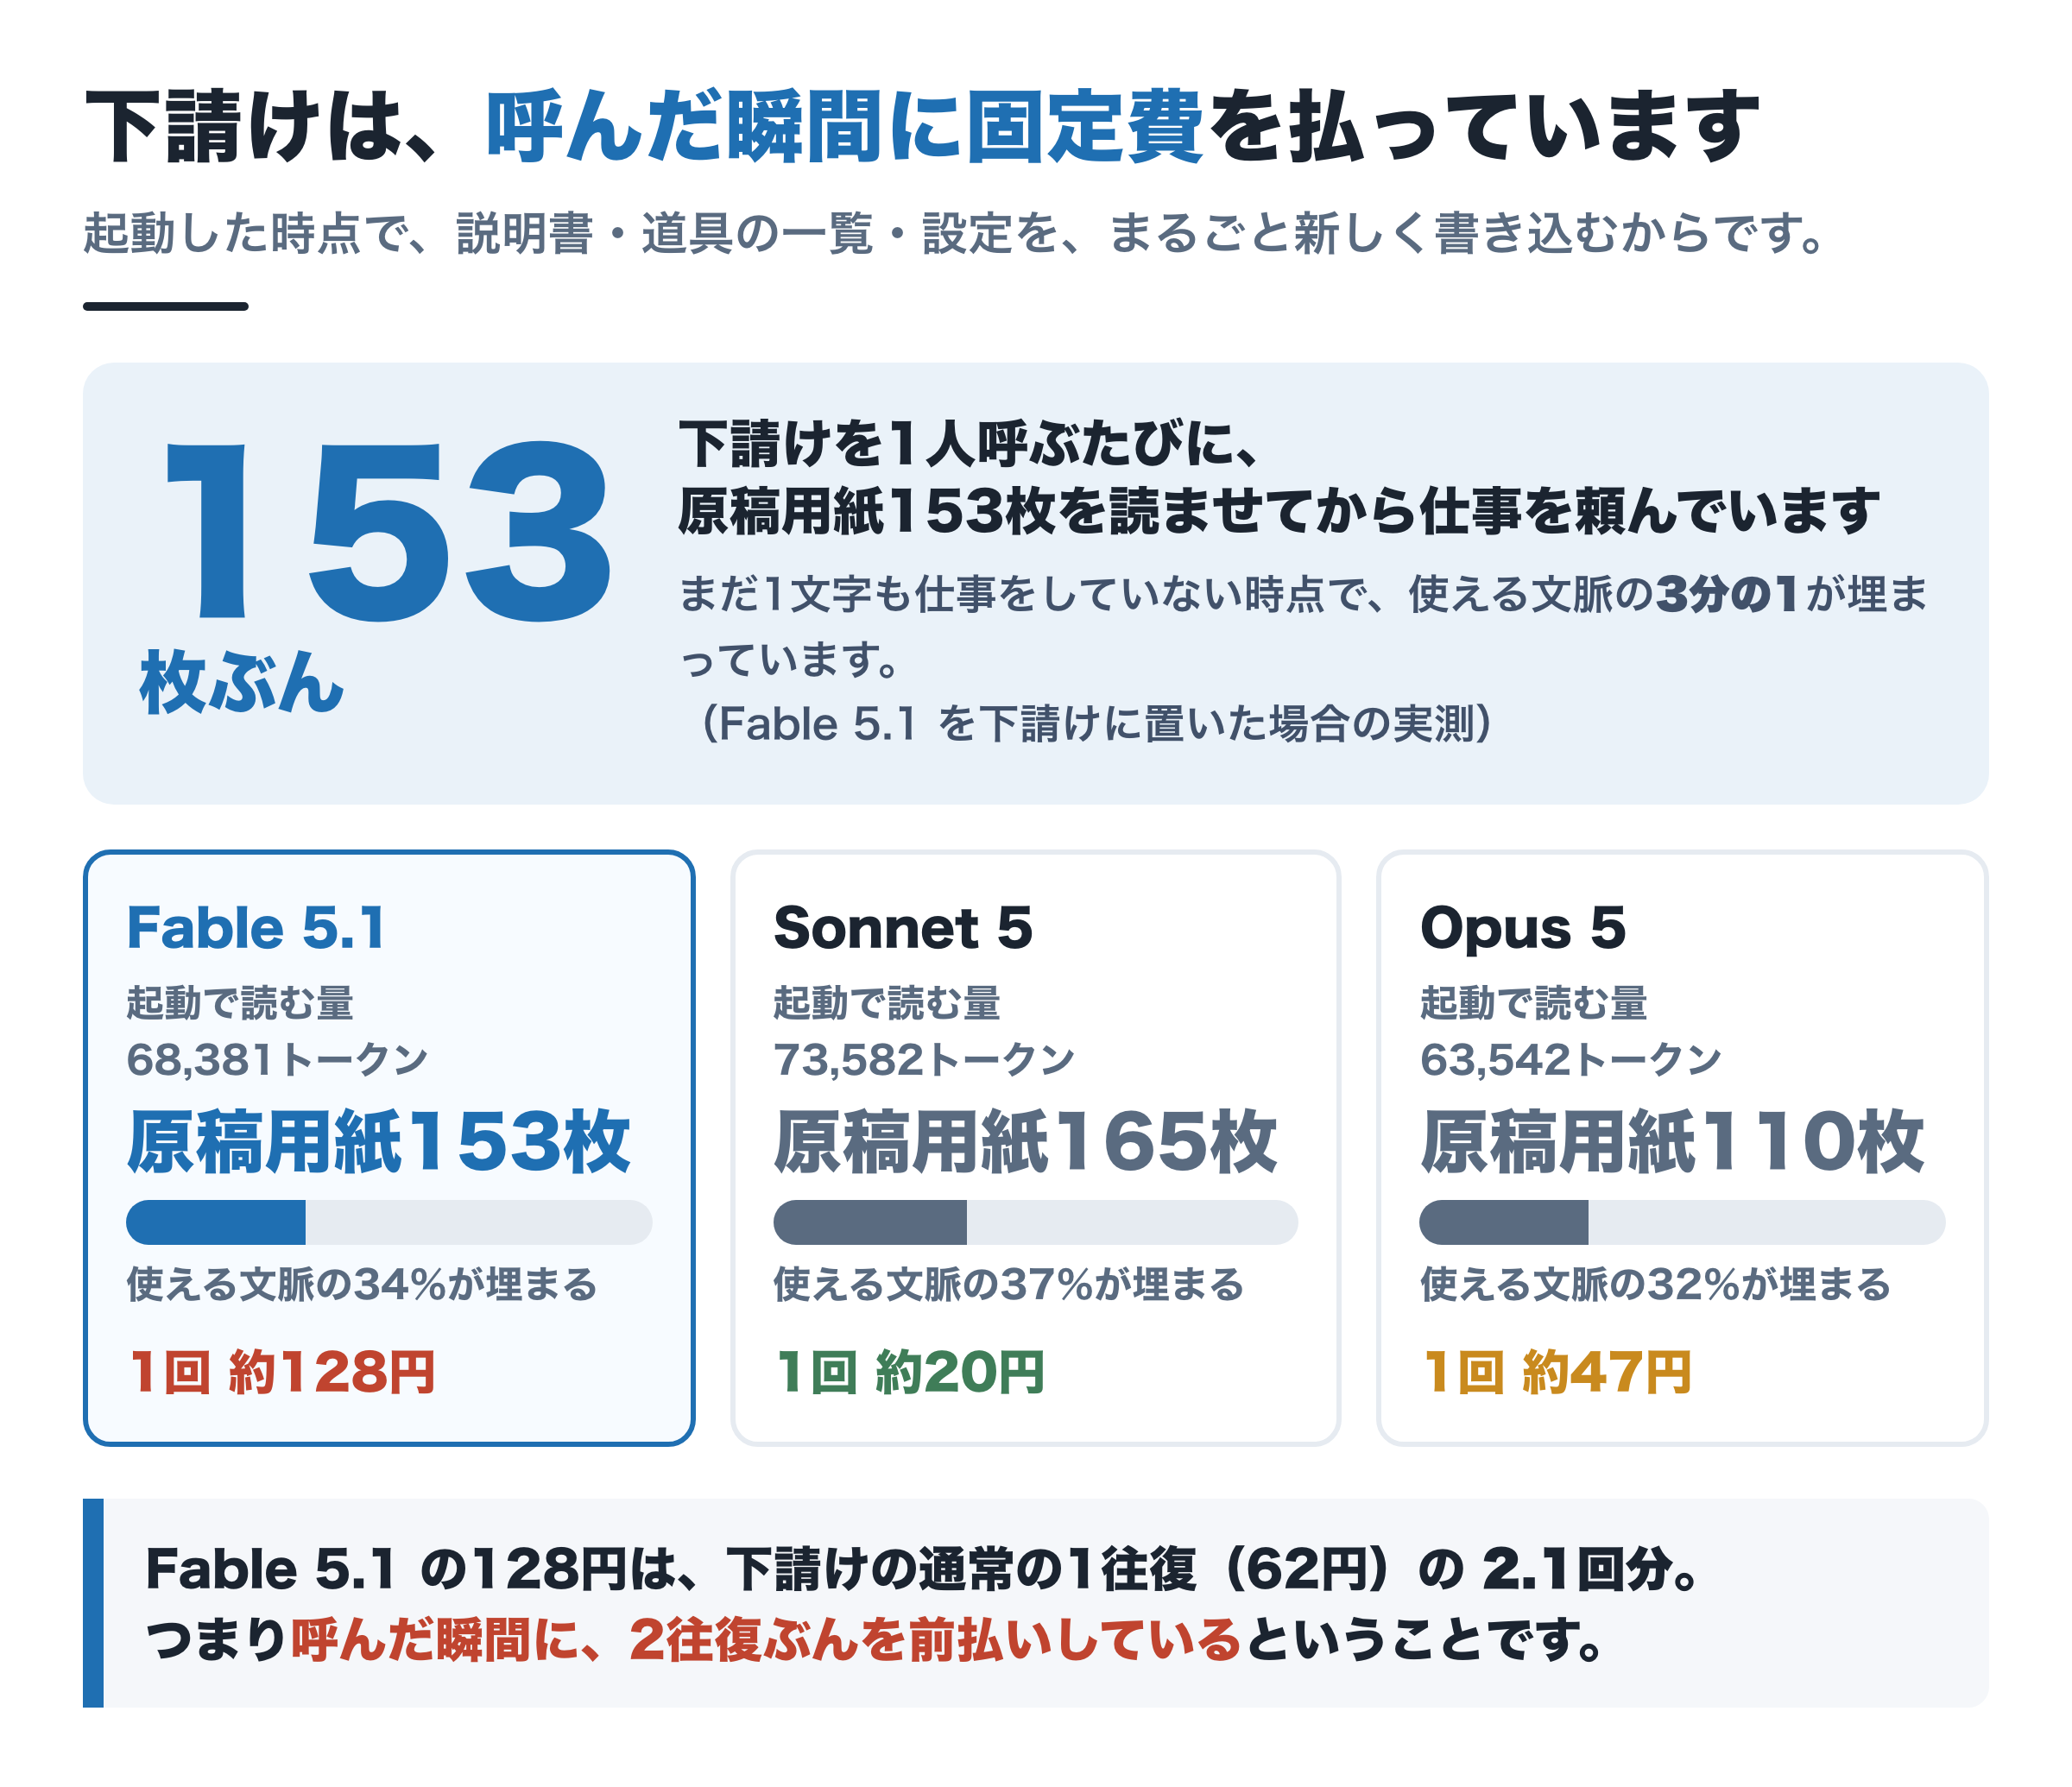
仮説3は「下請けに投げれば本体の会話が伸びないので節約になる」でした。
前半は正しかったです。
下請けを1回呼んでも、本体の会話に積まれるのは中央値で1,993トークンだけ。
これは公式の説明とも一致しました。
Each subagent might explore extensively, using tens of thousands of tokens or more, but returns only a condensed, distilled summary of its work (often 1,000-2,000 tokens).
後半が間違っていました。
下請けは、起動するだけで固定費を払います。
| 下請けに置くモデル | 起動で読む量 | 実感すると | 文脈の何%が埋まるか |
|---|---|---|---|
| Fable 5 | 68,381トークン | 原稿用紙153枚 | 34% |
| Sonnet 5 | 73,582トークン | 原稿用紙165枚 | 37% |
| Opus 5 | 63,542トークン | 原稿用紙142枚 | 32% |
つまりどういうことか。
下請けを1人呼ぶたびに、原稿用紙153枚を読ませてから、仕事を頼んでいます。
まだ1文字も仕事をしていない時点で、使える文脈の3分の1が埋まっています。
だから分岐点がある
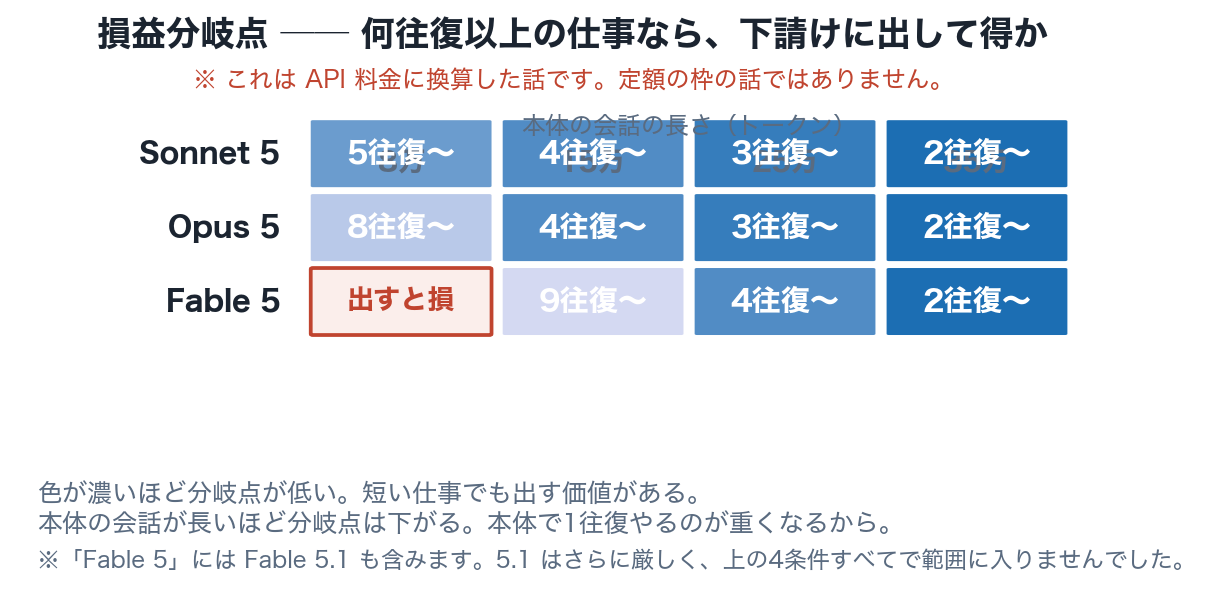
前払いがあるということは、その前払いを取り返せるだけの仕事量がないと、出すだけ損ということです。
本体の会話が8万トークンのとき、Opus 5を下請けに出して得になるのは、その仕事が8往復以上あるとき。
本体の会話が長くなっているほど、分岐点は下がります。
繰り返しますが、これは全部ドルの話です。
価格の形が、極端に偏っていました
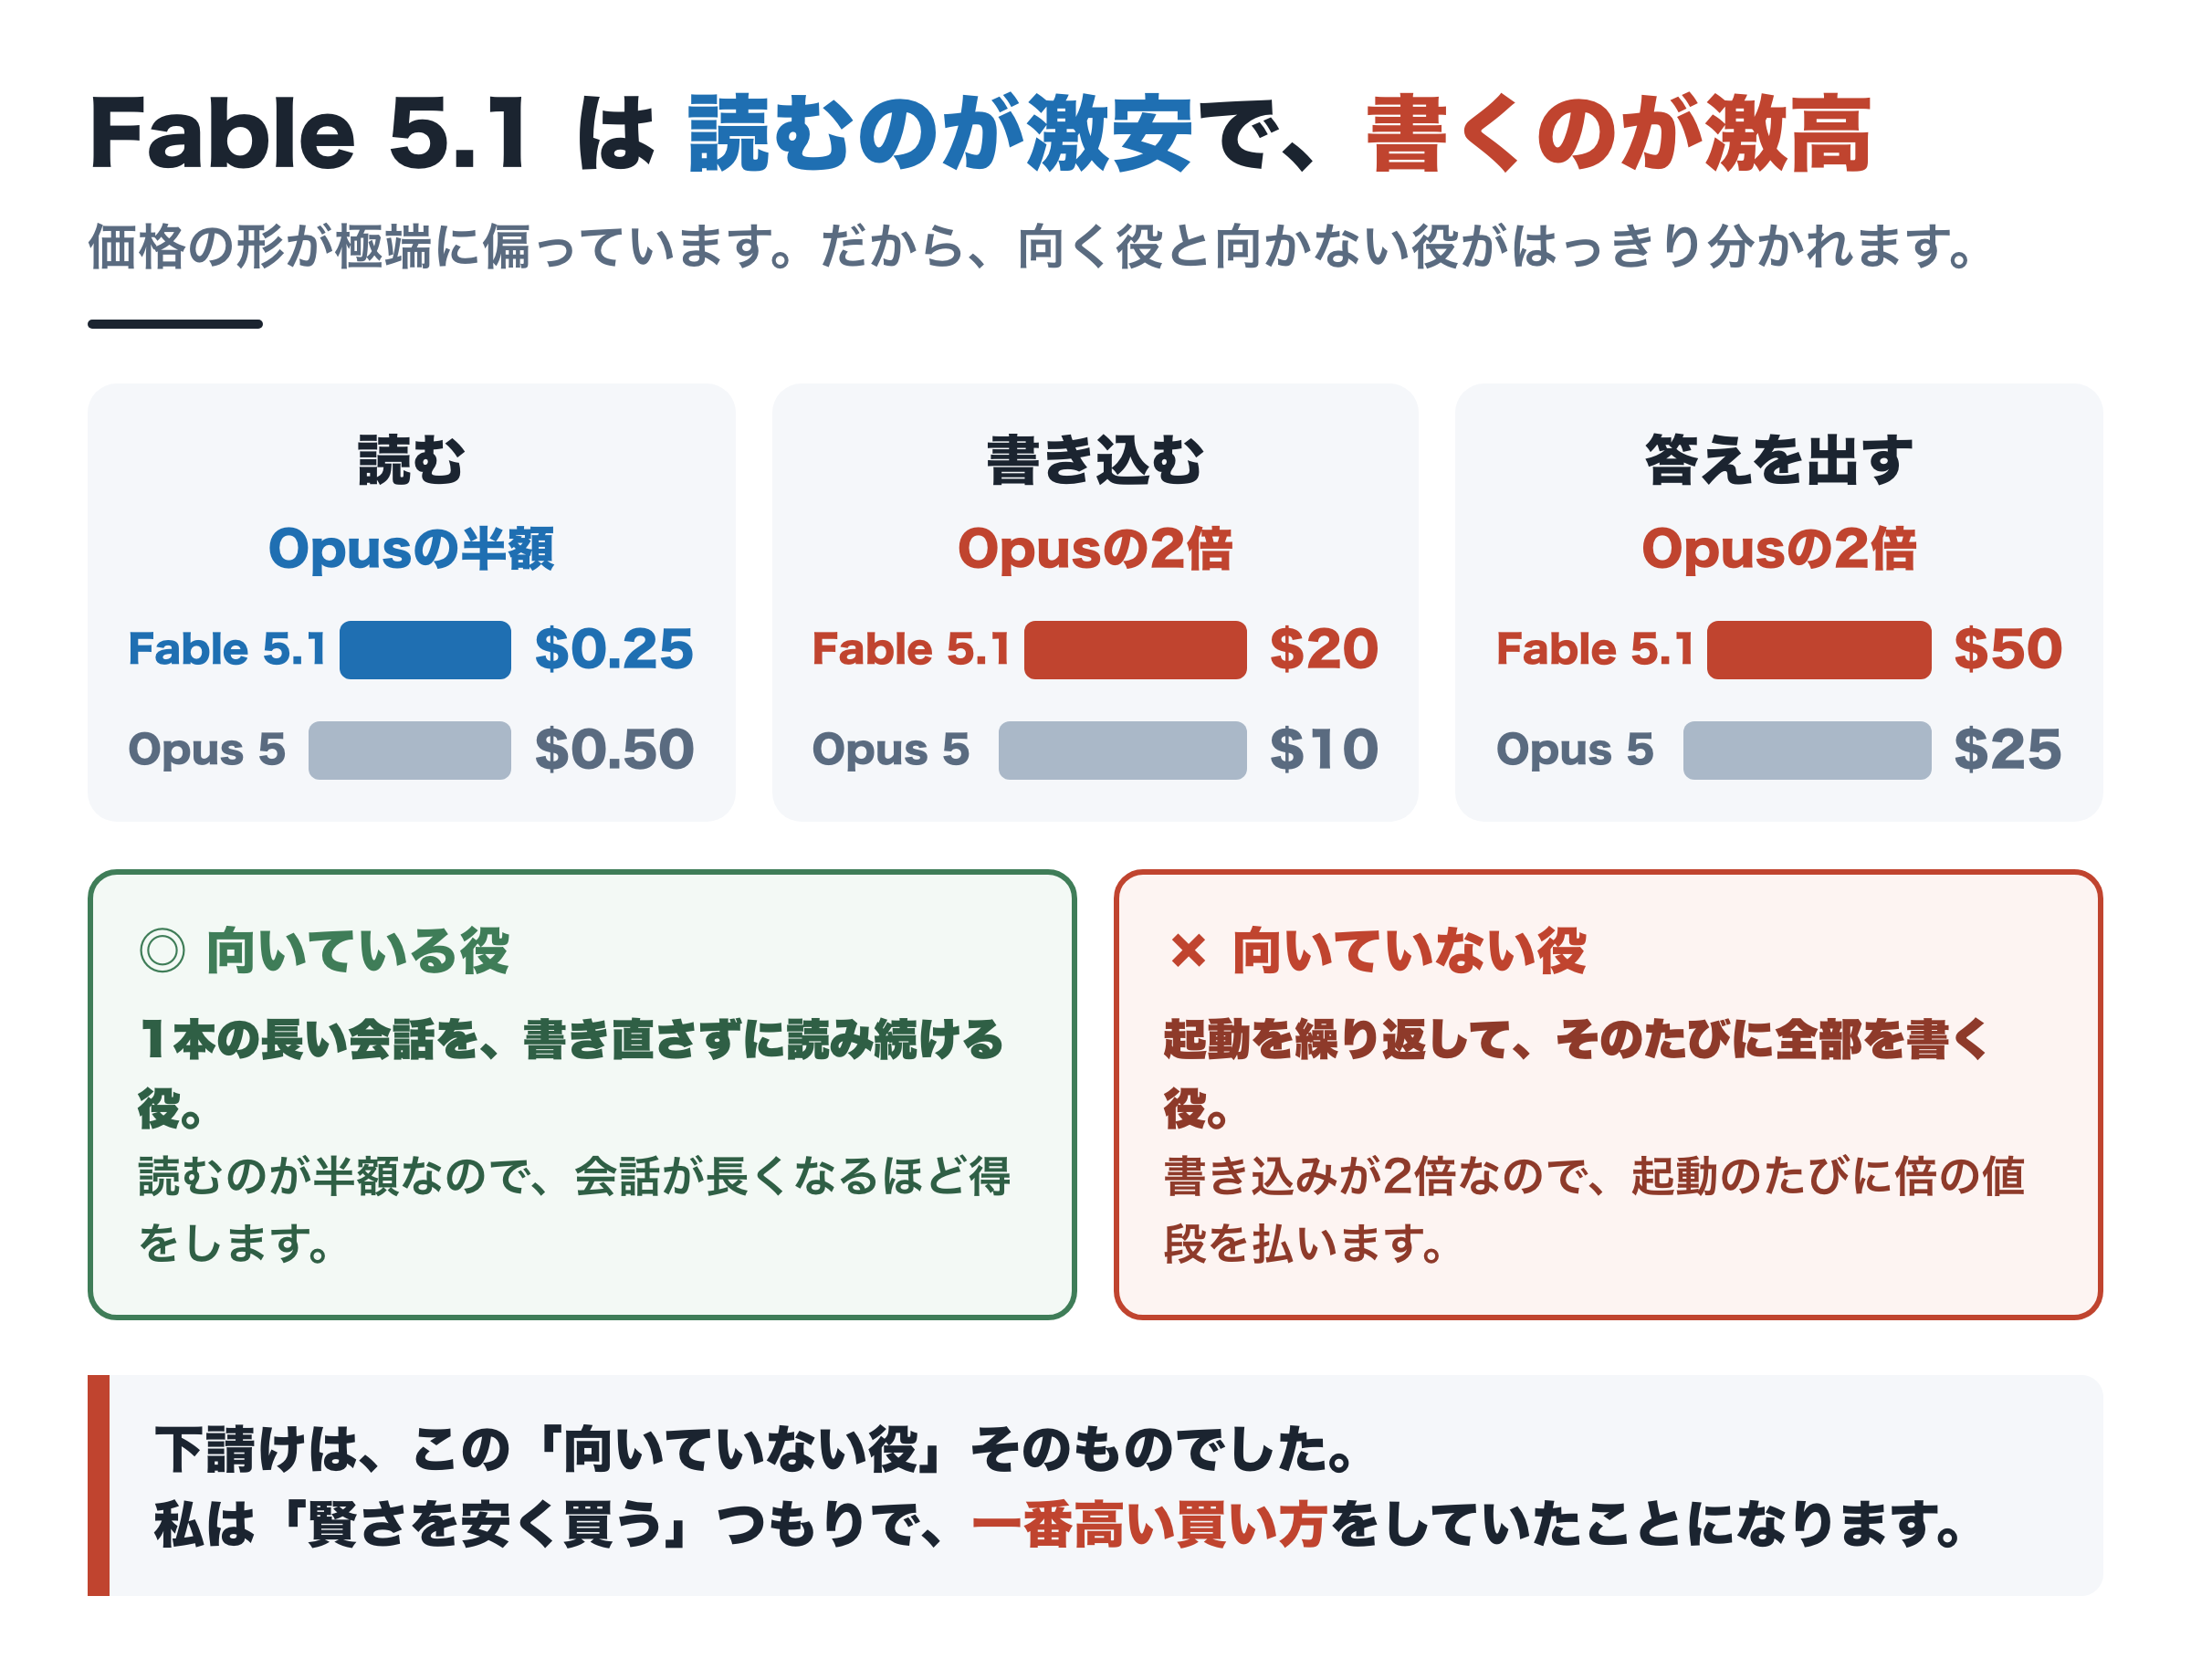
| 読む | 書き込む | 答えを出す | |
|---|---|---|---|
| Fable 5 | $0.25 | $20 | $50 |
| Opus 5 | $0.50 | $10 | $25 |
読むのはOpusの半額。
でも書き込むのと答えを出すのは2倍です。
読むのが激安で、書くのが激高。
この形は「長い会話を、書き直さずに読み続ける役」に向いています。
そして「起動を繰り返して、そのたびに全部を書く役」に、一番向いていません。
※ この記事で「Fable 5」と書くとき、Fable 5.1 も含みます。上の価格は Fable 5.1 のものです。
ドルで計算すると、こういう結論が出ます。
Fableは本体に置くほうが、下請けに置くより安い。
計算のやり方を4回変えても、この向きだけは変わりませんでした。
相談役を常駐させても、安くはなりませんでした
仮説2は「相談役として立ち上げっぱなしにすれば安い」でした。
ここで「相談役」を説明します。
サブエージェントは、ふつう使い捨てです。
でも名前を付けて起動すると、そのまま生かしておけます。
名前を呼べば、新しく起動せずに、同じ相手が答えます。
記憶については公式の言うとおりでした。
Resumed subagents retain their full conversation history, including all previous tool calls, results, and reasoning.
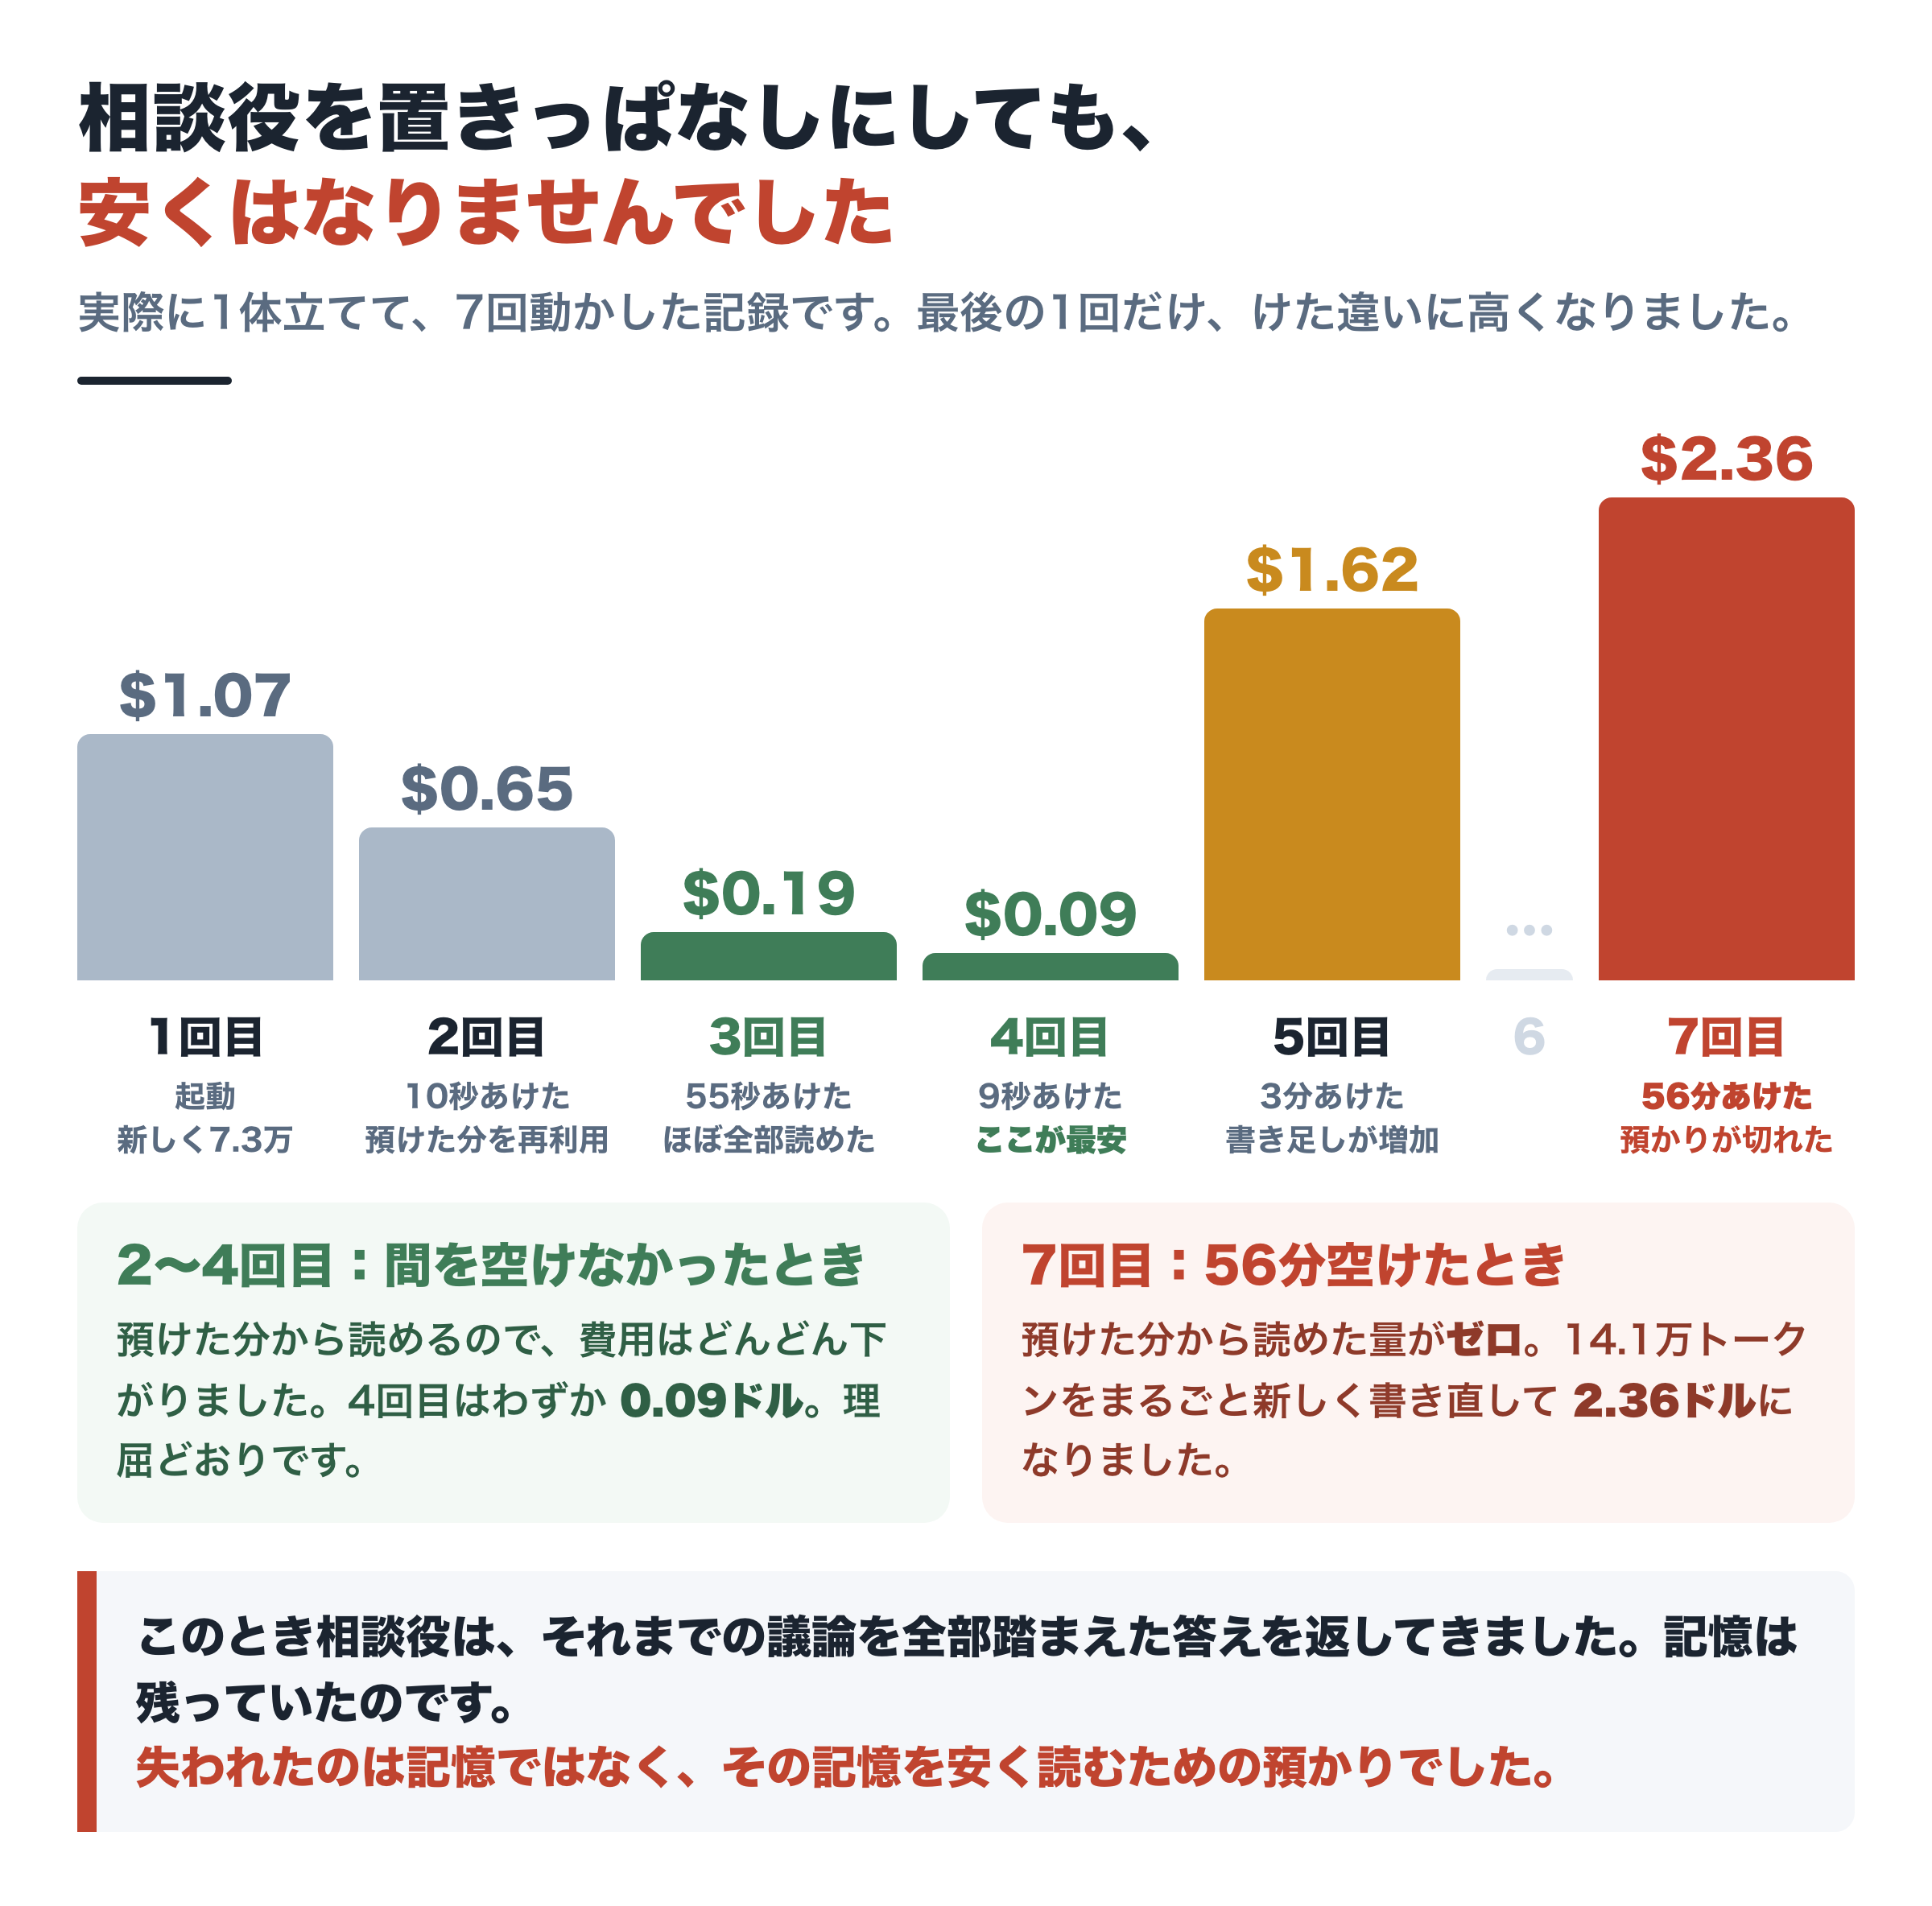
実際に1体立てて動かした記録がこれです。
| 何回目 | 新しく書いた量 | 保存から読んだ量 | 費用 | 前の手からの間隔 |
|---|---|---|---|---|
| 1 | 73,009 | 0 | $1.07 | 起動 |
| 4 | 2,712 | 125,530 | $0.09 | 9秒 |
| 7 | 141,449 | 0 | $2.36 | 3,395秒 |
4回目はわずか0.09ドル。理屈どおりです。
問題は7回目です。
前の手から56分空いています。
保存から読んだ量がゼロ。
14.1万トークンを、まるごと新規で書き直しました。
このとき、相談役は記憶を失っていません。
それまでの議論を全部踏まえた答えを返してきました。
失ったのは記憶ではなく、記憶を安く読むための保存です。
つまり、常駐で買っていたのは安さではありませんでした。
買っていたのは、説明し直さなくていいことと、経緯を踏まえた答えです。
ここも念のため書いておきます。
これは「1回の相談あたりの単価」の話です。
同じ仕事をさせたときに、1回いくらかかるかを比べています。
「相談役を置くこと自体が無駄」という話ではありません。
ここまでが、API料金表を使って出した答えです。
私はこれで満足していました。
節約術として、そのまま記事にするつもりでした。
でも、自分の体感とまるで合わなかったのです。
第6章 じゃあ、サブスクではどうなのか
計算は「Fableは本体に置け」と言った。体感は真逆だった
ドルの計算は「Fableは本体に置くほうが安い」と言いました。
でも私の体感はこうです。
Fableを本体で回すと、5時間枠が2時間半で溶ける。
Opus本体で要所だけFableを呼ぶなら、そもそも5時間枠に引っかからない。
計算と体感が、正面から食い違っていました。
そこで、計算ではなく止められた記録を数えました。
| モデル | 使用量の割合 | 止められた割合 | 過剰の倍率 |
|---|---|---|---|
| Fable 5 | 21.3% | 74.7% | 3.51倍 |
| Opus 5 | 61.0% | 24.1% | 0.39倍 |
| Sonnet 5 | 16.5% | 0.0% | 0.00倍 |
Fableは使用量の2割しかないのに、止められた回数の7割を占めていました。
そしてSonnetは、16.5%使って一度も止められていません。
体感のほうが正しかったのです。
公式には、最初から書いてありました
Fableについて、公式にこうあります。
You can use up to 50% of your weekly usage limits on Fable models at no extra cost.
They draw from your plan's regular weekly usage limits and use them faster than other Claude models.
出典 Claude Fable models on your plan
日本語にすると——
週間利用上限の最大50%まで、Fableを追加費用なしで使える。
Fableはプランの通常の週間上限から消費され、他のClaudeモデルより速く消費する。
2つ、書いてあります。
ひとつ。Fableは週の半分までしか使えない。 これはMaxプランなどの話で、Proプランでは最初からプラン上限に含まれません。
ふたつ。Fableは他より速く枠を食う。
私はこれを知らずに、API料金表で最適化していました。
そして、Anthropicは「何倍速いか」を書いていません
ここが肝心です。
公式は「速く消費する」としか書いていません。
何倍なのか、どう計算するのか、どこにも公開されていません。
ヘルプも、ドキュメントも、ニュースも、エンジニアリングブログも当たりました。
数字は1つも出てきません。
ただし、昔は書いてありました
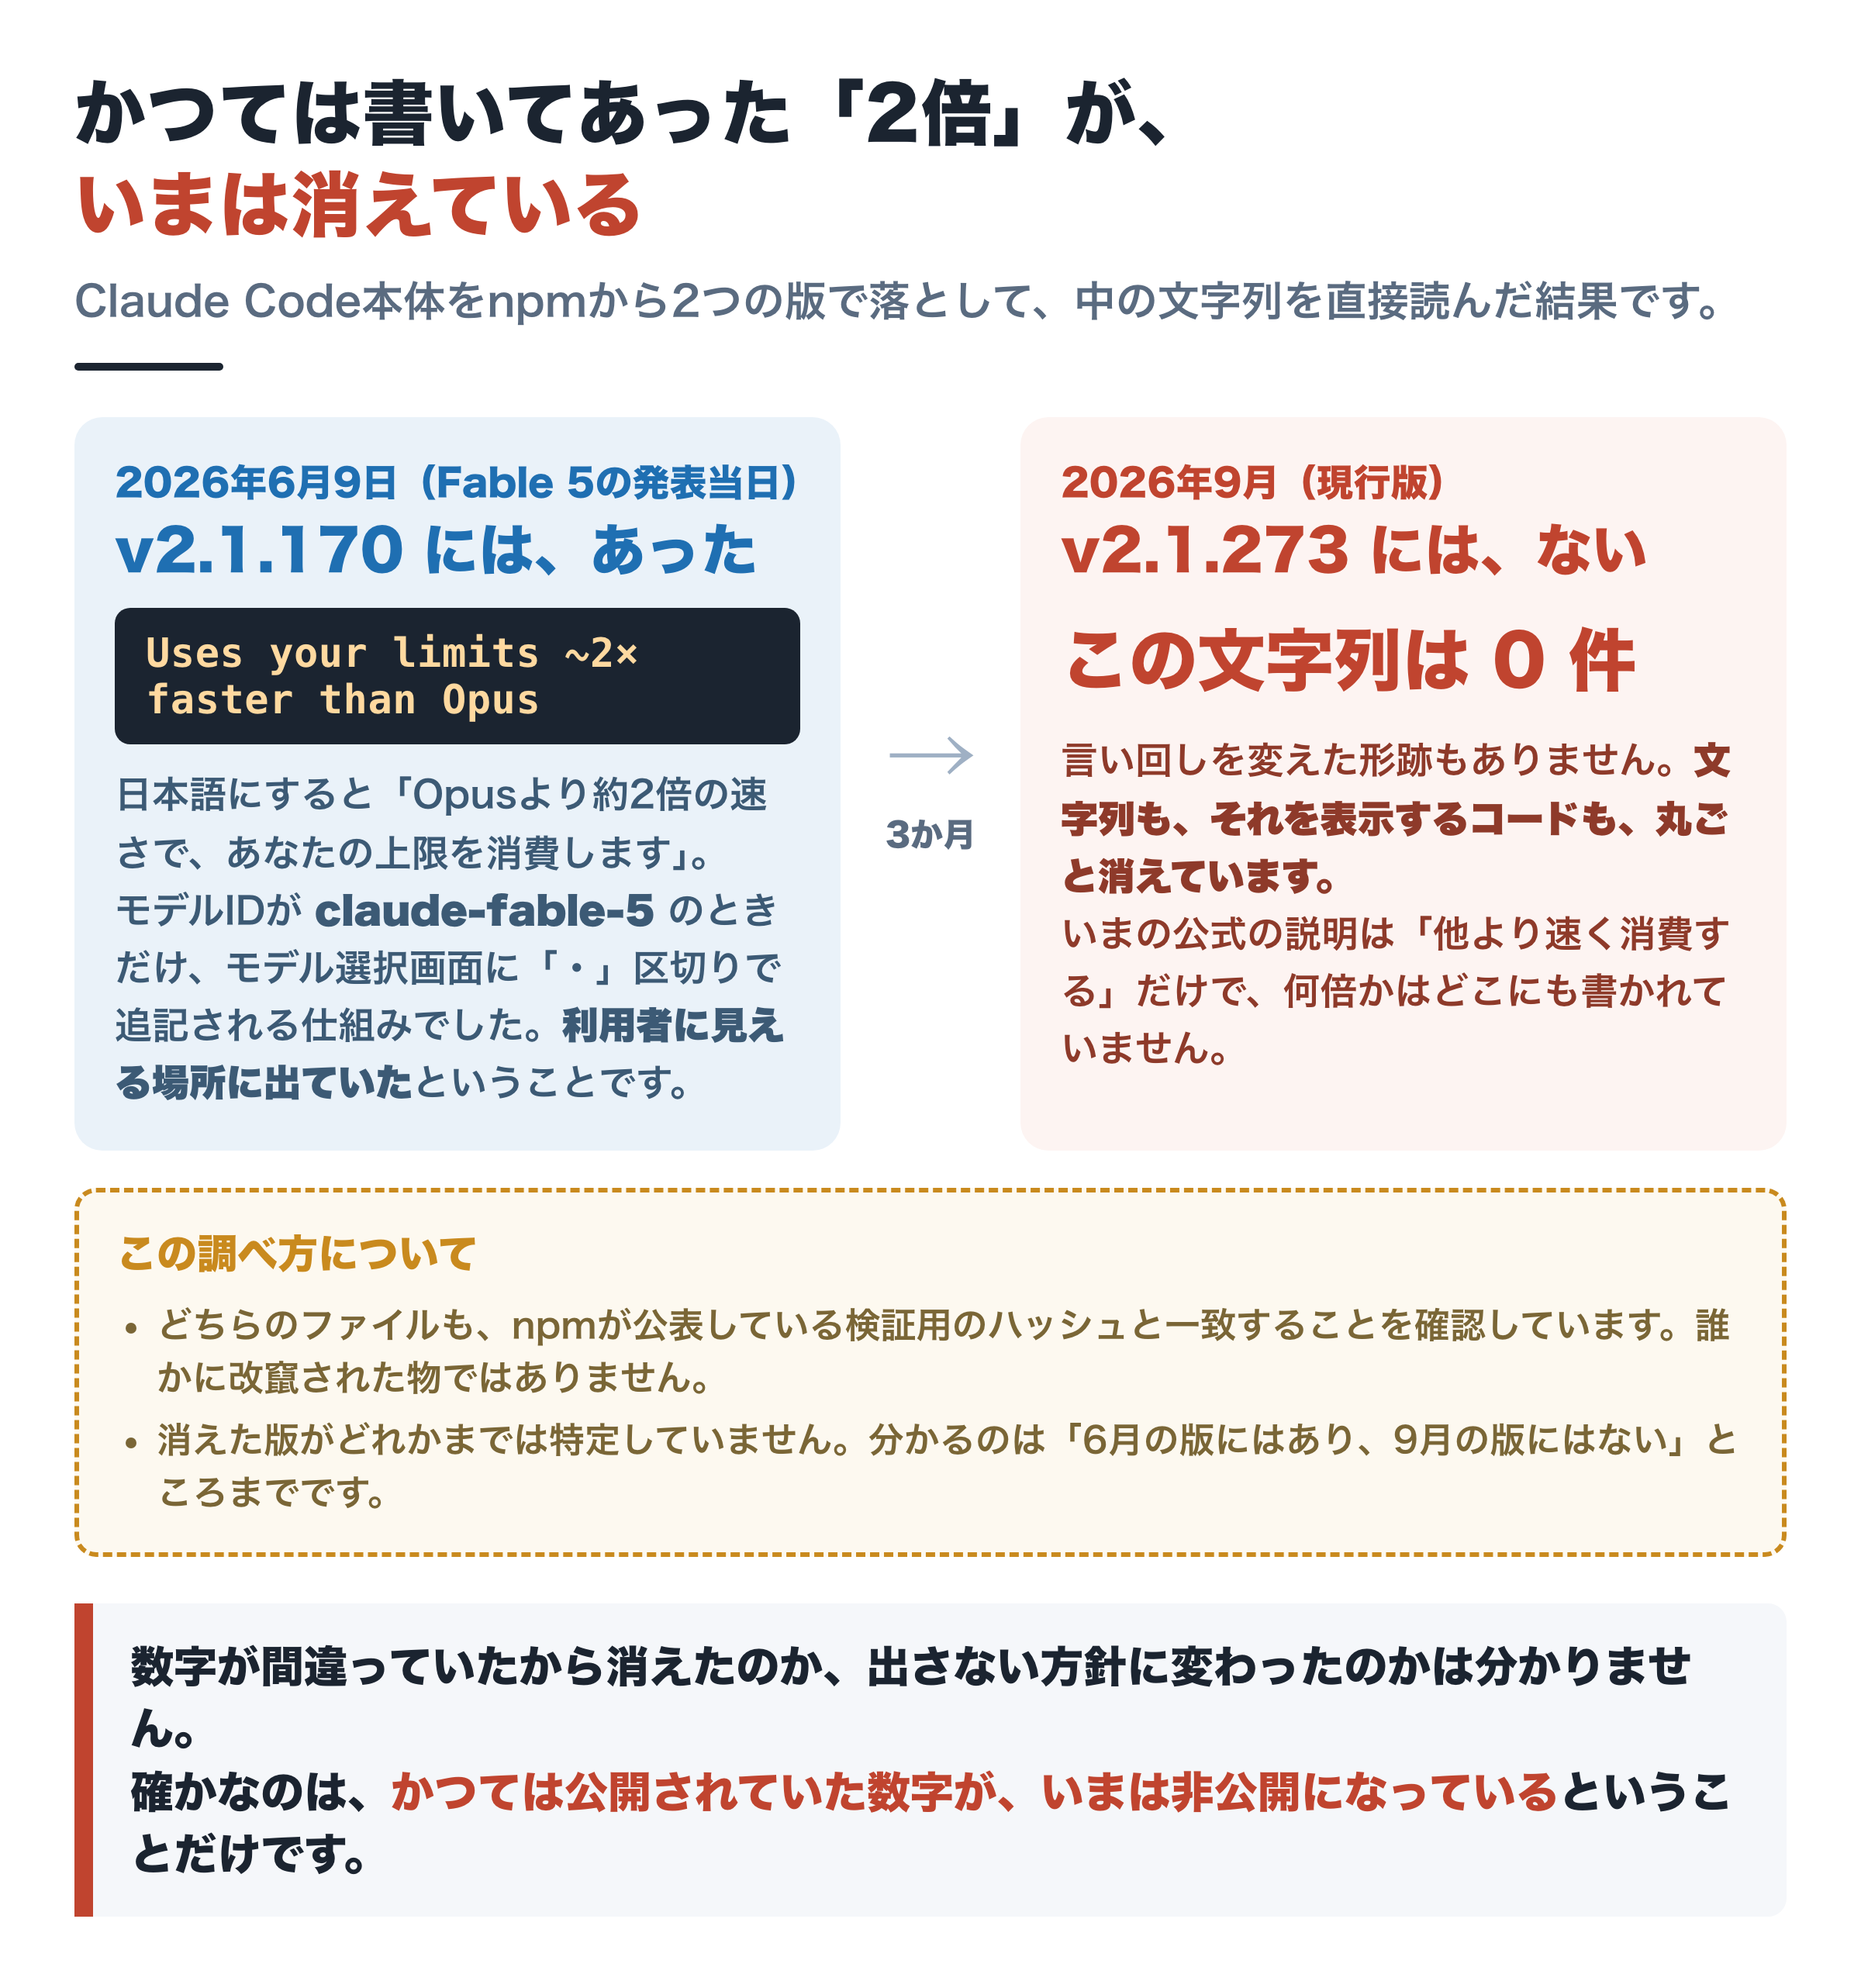
Claude Code本体を、npmから2つのバージョンで落として、中の文字列を直接読みました。
v2.1.170(2026年6月9日ビルド=Fable 5の発表当日) のコードの中に、これがありました。
Uses your limits ~2× faster than Opus
条件分岐まで読めます。
モデルIDが claude-fable-5 のときだけ、モデル選択画面に「・」区切りで追記される仕組みでした。
そして現行版のv2.1.273(2026年9月ビルド)を同じ方法で調べたら、この文字列は0件。
言い回しを変えた形跡もなく、該当するコードごと消えていました。
(どちらのファイルも、npmが公表している検証用のハッシュと一致することを確認しています。改竄された物ではありません。)
Anthropicは発表初日に「Opusの2倍」とアプリの中に書き、その後どこかの版で消しています。
つまり、かつては公開されていた数字が、いまは非公開になっているということです。
なぜ、ドルの比率と枠の比率がズレるのか
ここで他社を見ると、話がはっきりします。
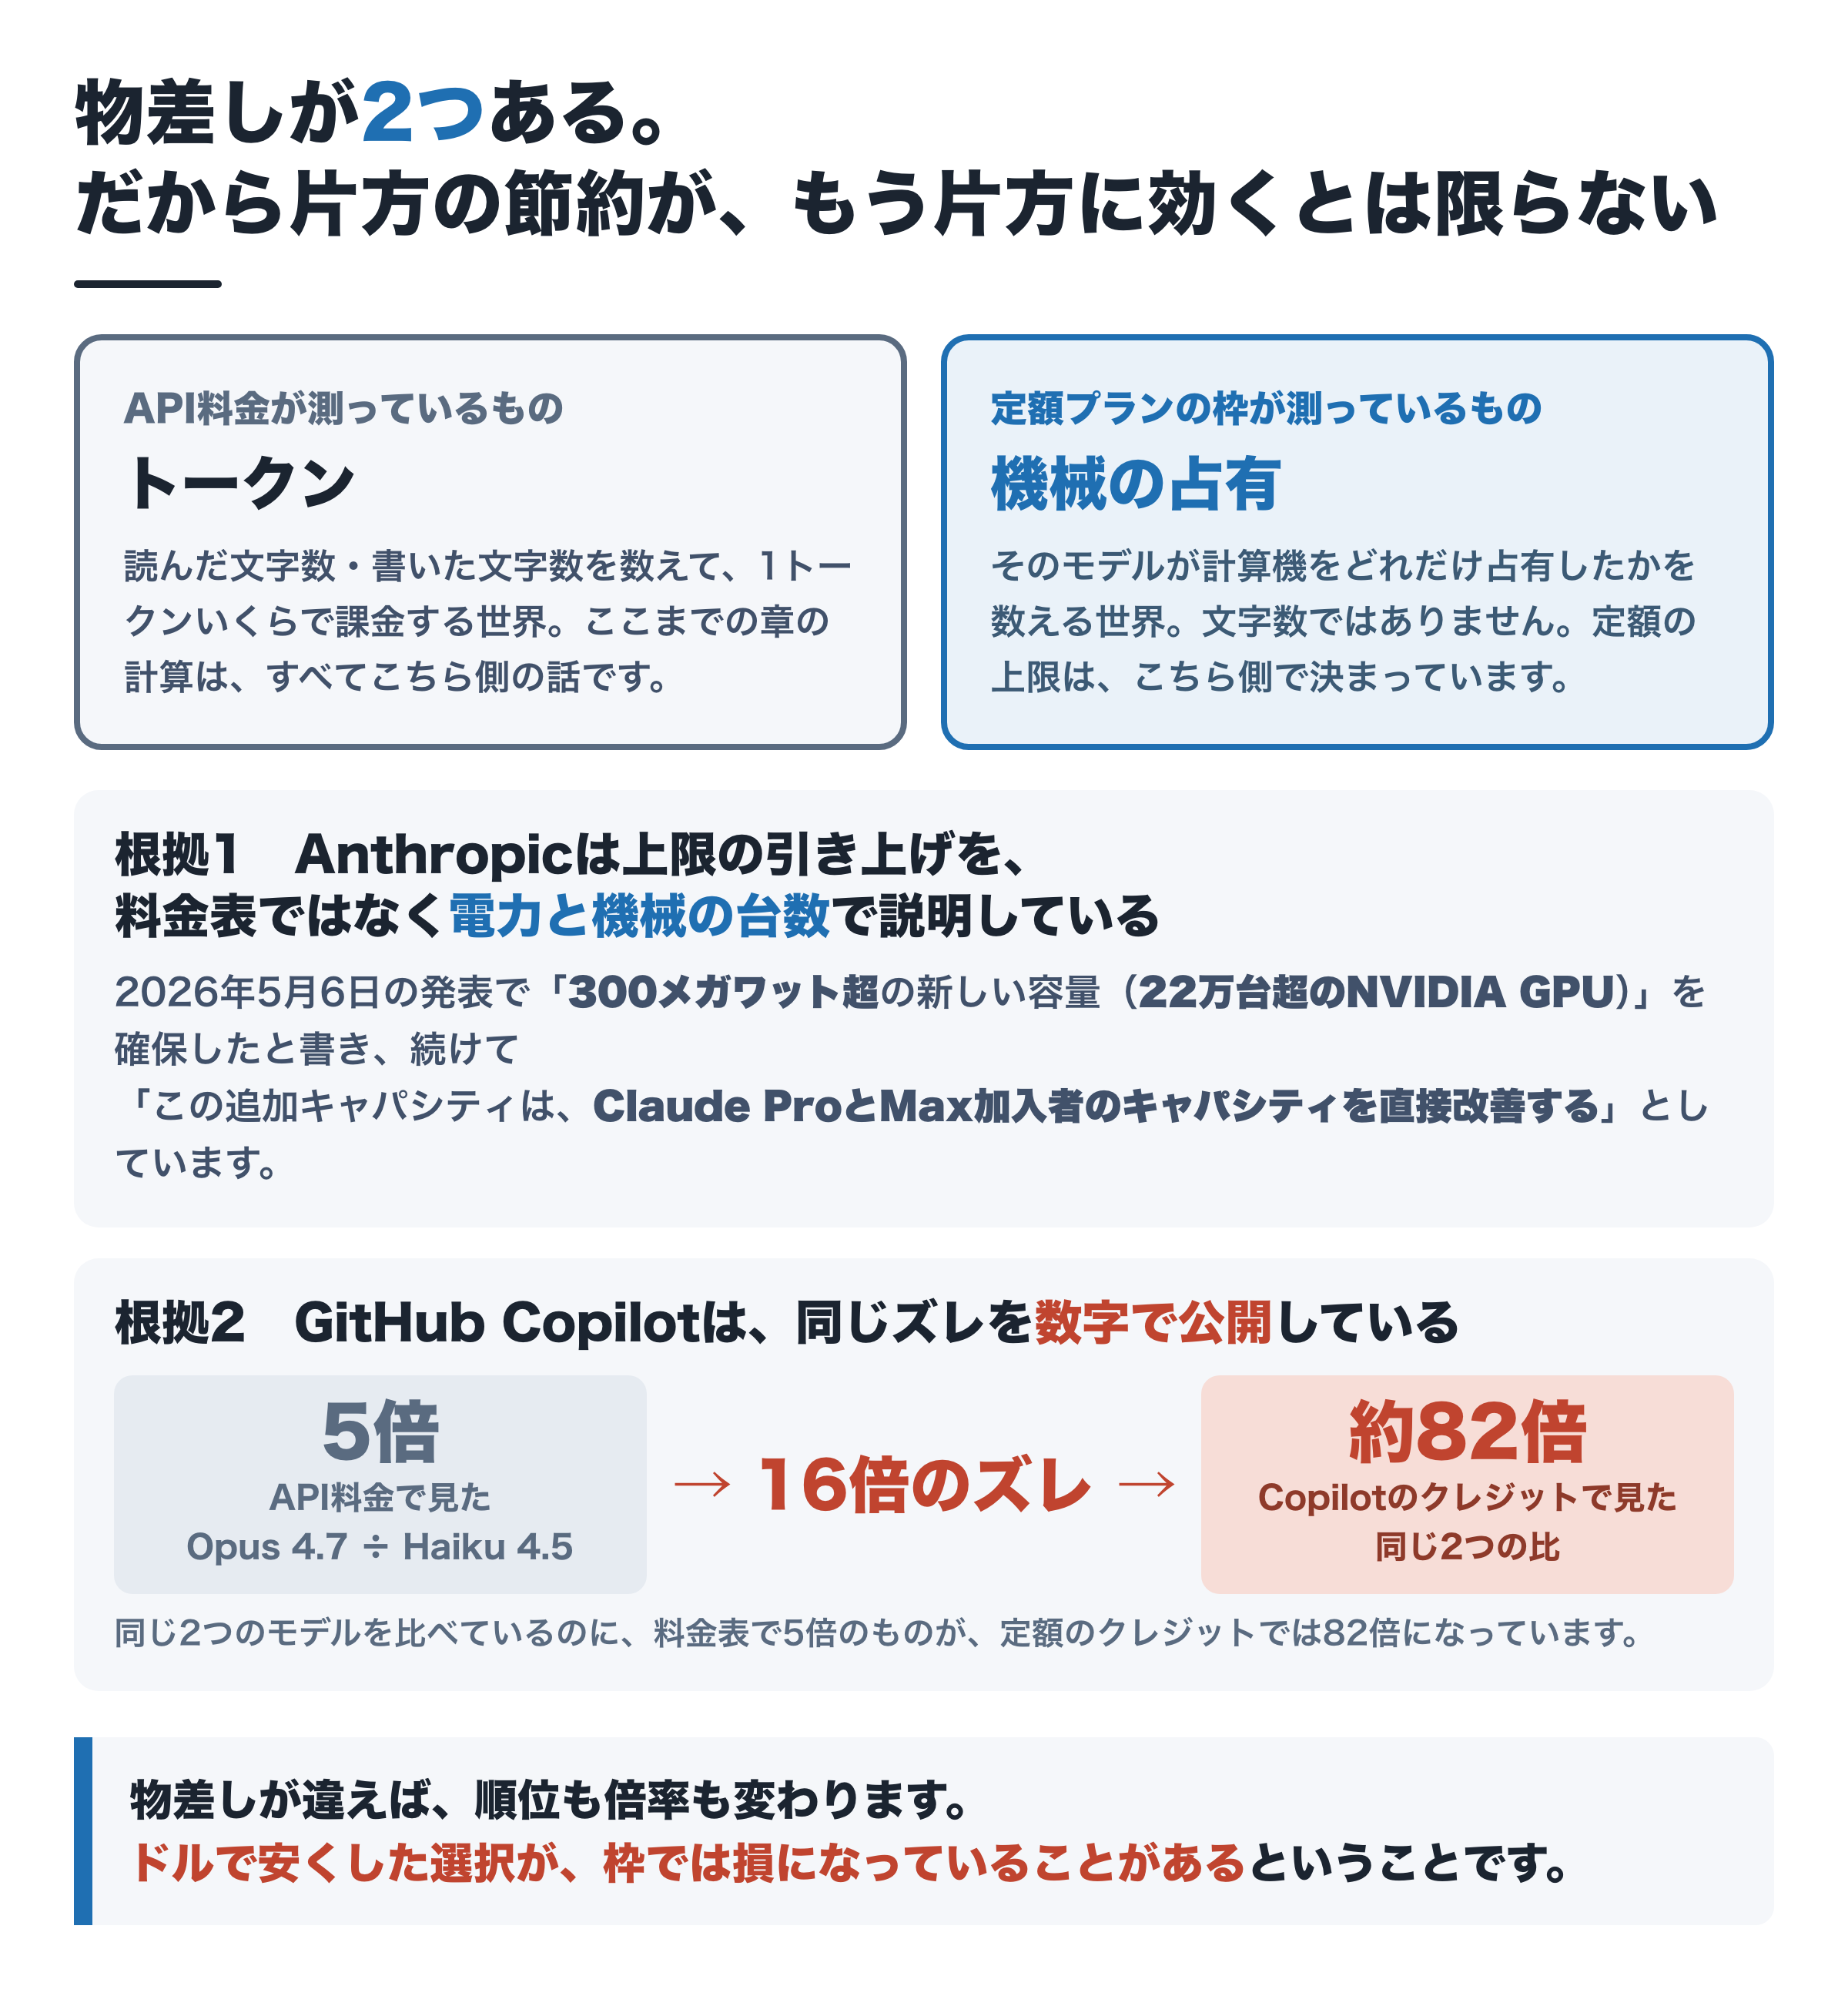
GitHub Copilotは、モデルごとの消費倍率を数字で公開しています。
| モデル | API出力単価 | API料金の比 | Copilotの倍率 | クレジットの比 |
|---|---|---|---|---|
| Haiku 4.5 | $5 | 1.0 | 0.33 | 1.0 |
| Sonnet 4.6 | $15 | 3.0倍 | 9 | 27.3倍 |
| Opus 4.7 | $25 | 5.0倍 | 27 | 81.8倍 |
API料金では5倍のものが、クレジットでは82倍。16倍のズレです。
GitHubは理由も公開しています。
For agentic features, only the prompts you send count as premium requests; actions Copilot takes autonomously to complete your task, such as tool calls, do not.
「あなたが送ったプロンプトだけが数えられる。ツール呼び出しなど、自律的に行う動作は数えない」
つまり1クレジットは「1リクエスト」ではなく「お願い1件まるごと」です。
だから1回のお願いで何十回もツールを叩いて長時間働くモデルほど、1件あたりの消費が跳ね上がります。
ひとつ断っておきます。
Copilotは「回数」で数えていますが、Claude Codeは「トークンの量」で数えています。
本体のコードの中に「キャッシュ読みは0.1倍、書き込みは2倍、出力は5倍で重みをつけて測れ」と書いてありました。
設計が違います。
Copilotをここで出したのは「料金の比と枠の比はズレることがある」という実例としてであって、Claudeも同じ数え方だという意味ではありません。
そして、Anthropicは上限をメガワットで説明しています
決定的なのがこれです。
This gives us access to more than 300 megawatts of new capacity (over 220,000 NVIDIA GPUs) within the month.
This additional capacity will directly improve capacity for Claude Pro and Claude Max subscribers.
上限の引き上げを、料金表ではなくGPUの台数と電力で説明しています。
つまりどういうことか。
API料金は、トークンを測っています。
定額の枠は、機械の占有を測っています。別の物差しです。
Fableが重い、構造的な理由
公式から2つ、理由になりそうな事実が拾えます。
ひとつ。Fableは拡張思考をオフにできません。
You can't turn off thinking on Fable models, which always use extended thinking.
出典 Claude Code のコストに関する公式ドキュメント
常に考えるモデルです。
ふたつ。努力レベルを上げると、最大7倍のトークン差が出ます。
The high effort path generates roughly 7x more tokens to reach a higher confidence answer.
常に考えるモデルに、思考のぶんの出力がかかる。
それが「速く消費する」の中身だと思われます。
ただし、これは推測です。
Anthropicは理由を1行も説明していません。
そして、使用率そのものを測ったら、同じ数字が出ました
止められた記録を数えたあと、もう一段、測りました。
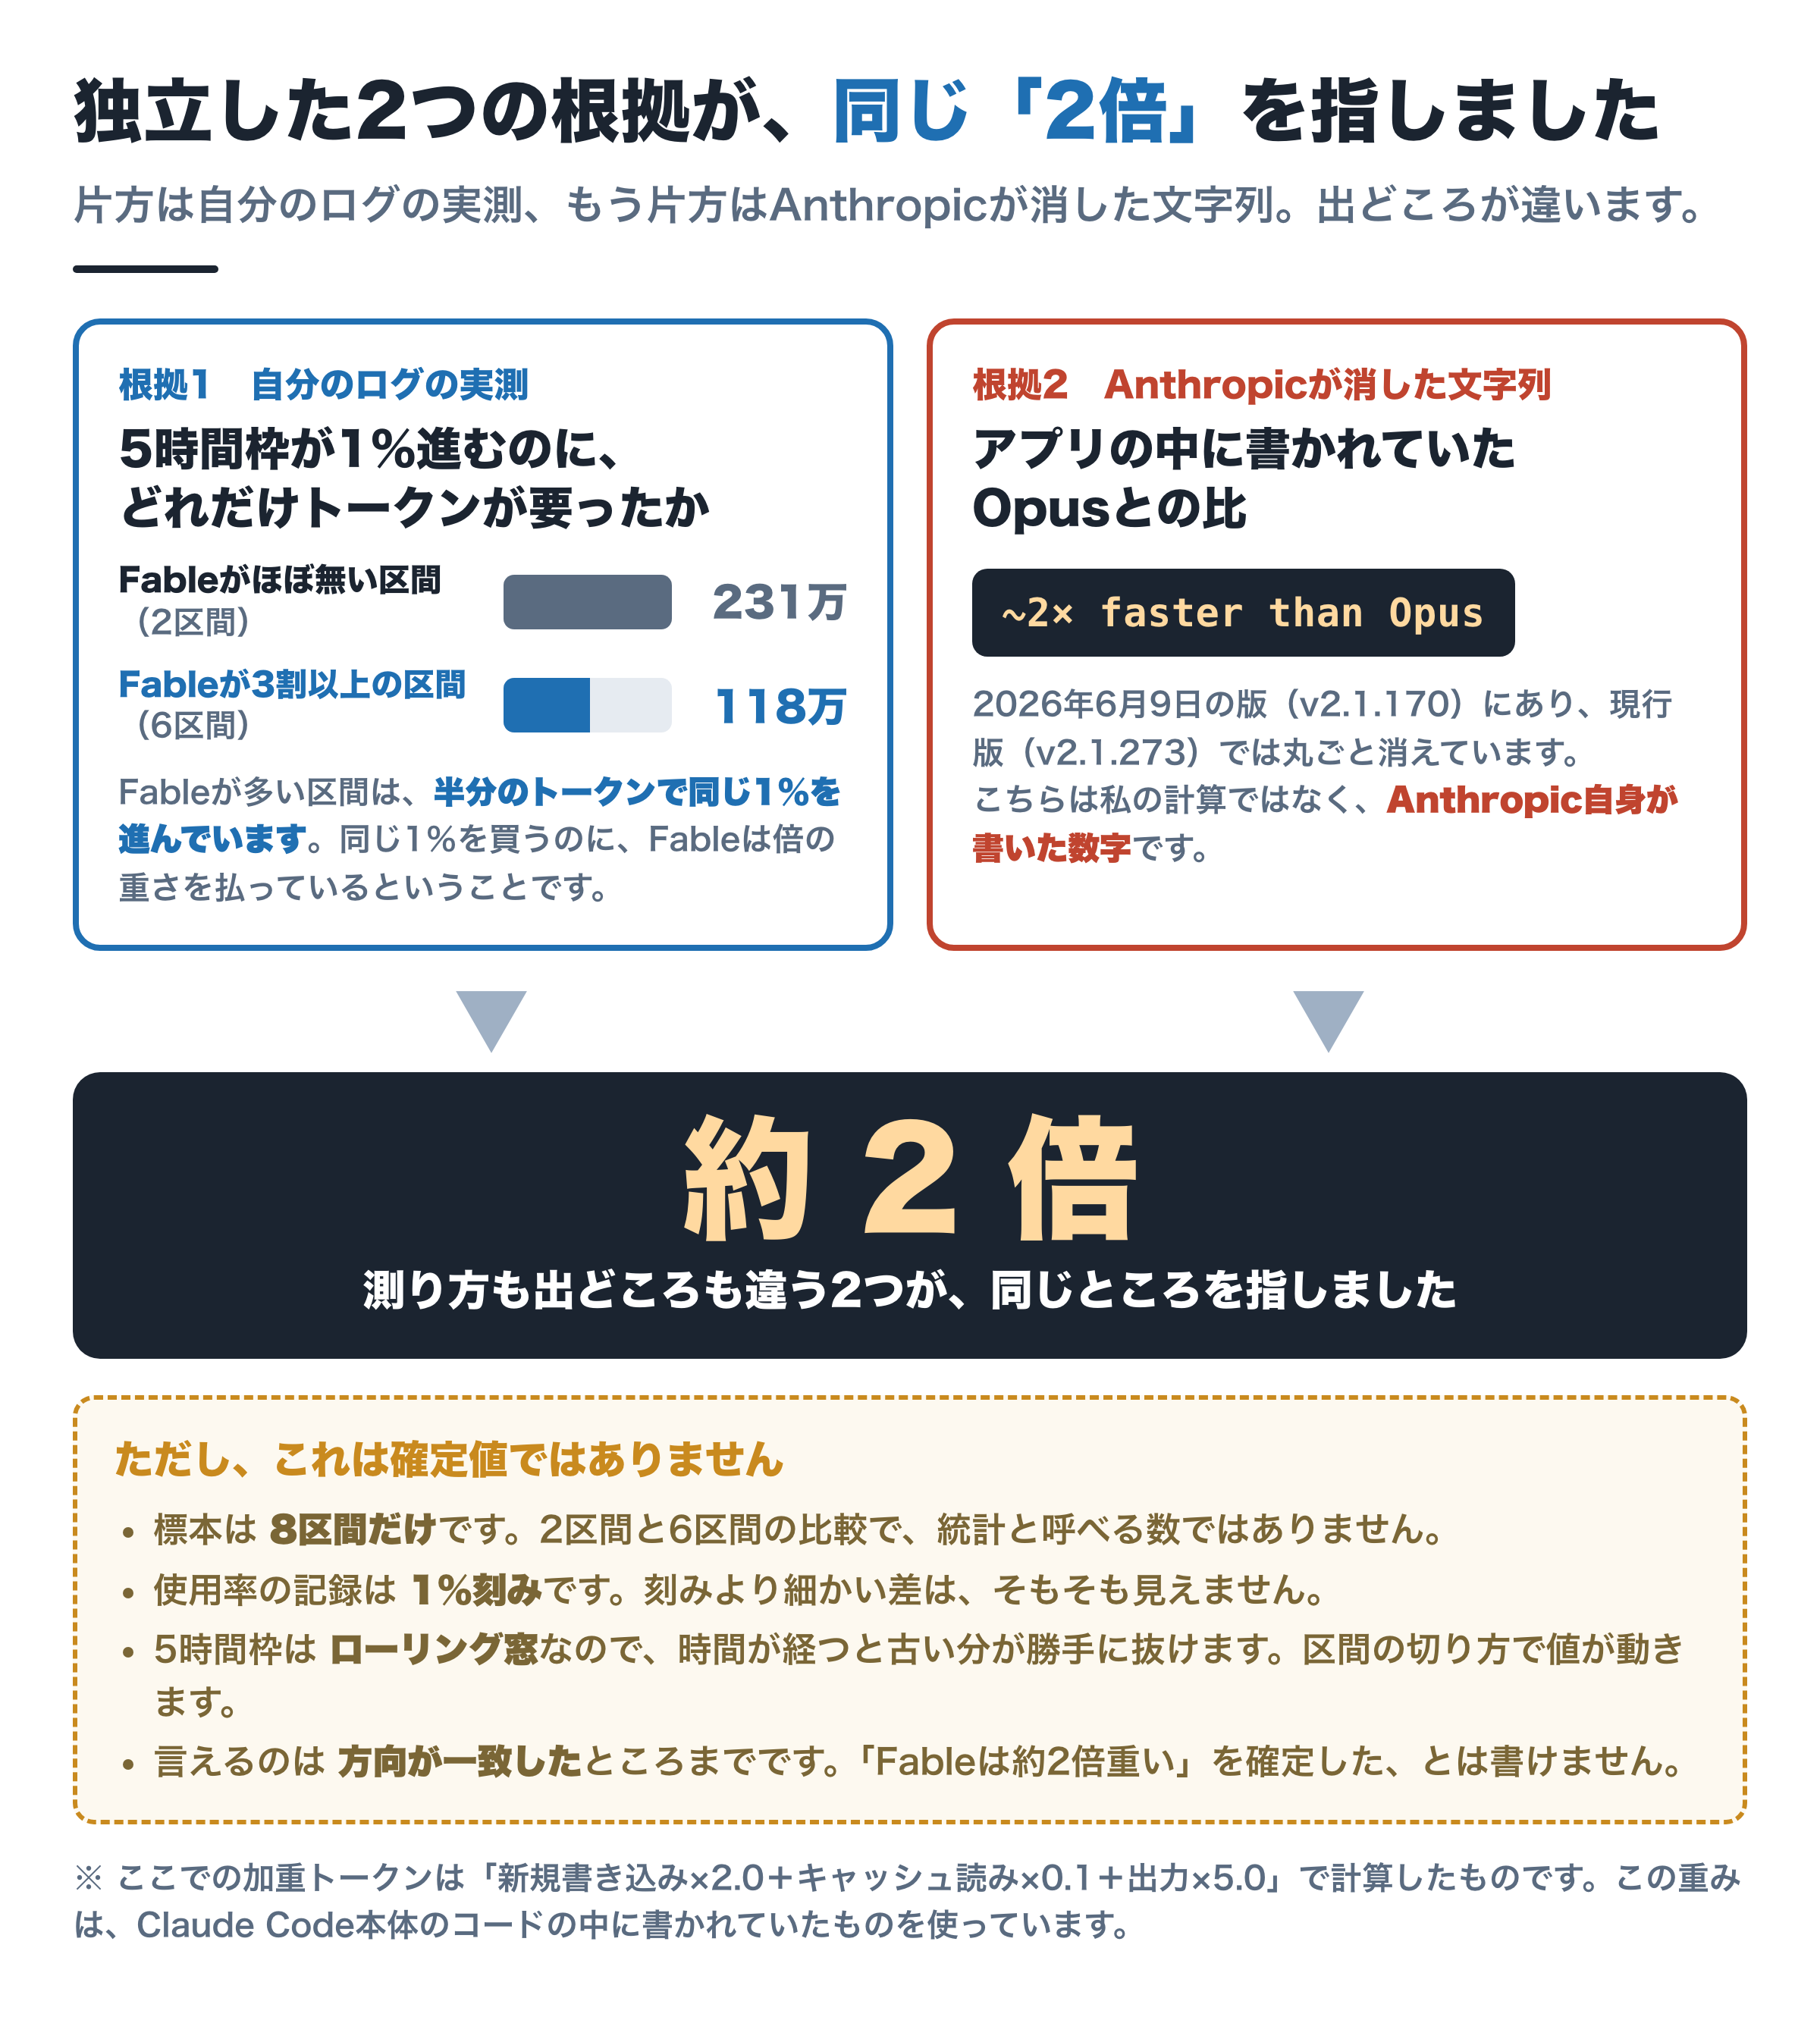
枠の使用率そのものを記録して、その間に何が動いていたかと突き合わせるやり方です。
Claude Codeは、問い合わせのたびに「5時間枠を何%使ったか」をサーバーから受け取っています。
それを30分ごとに記録しておけば、枠が1%進むのに、どれだけの仕事が必要だったかが分かります。
結果です。
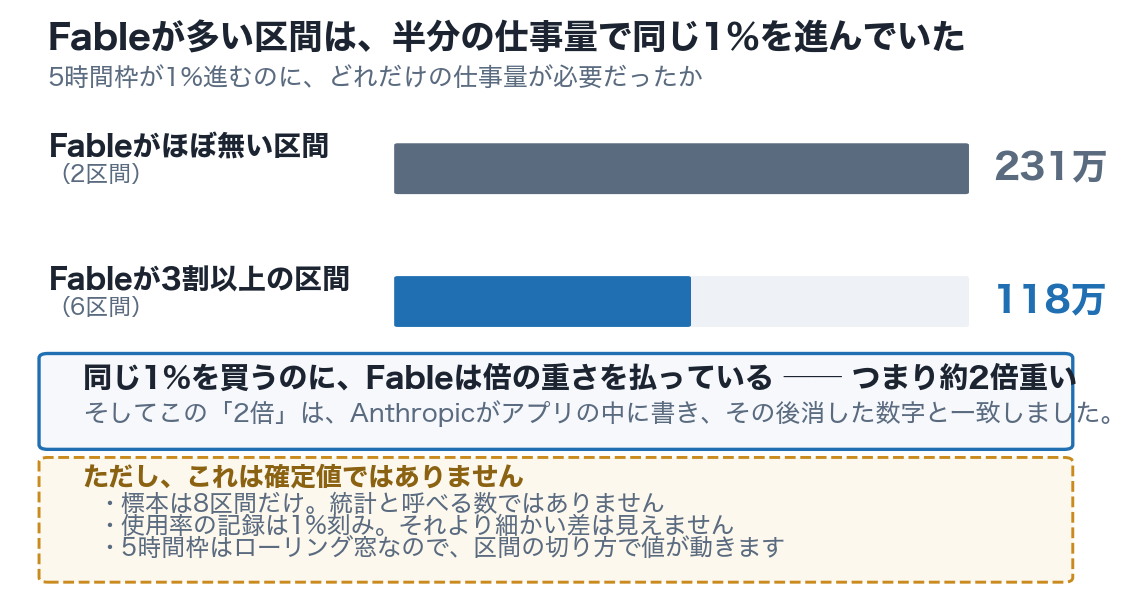
Fableが多い区間は、半分の仕事量で、同じ1%を進んでいました。
つまりFableは約2倍重い。
そして、この「2倍」は、Anthropicが削除したあの文字列と同じ数字です。
Uses your limits ~2× faster than Opus
まったく別の2つの経路から、同じ数字が出てきました。
ただし、これは確定値ではありません。
標本は8区間だけです。
使用率は1%刻みでしか取れません。
5時間枠はローリング窓なので、古い分が抜けていきます。
言えるのは「方向が一致した」までです。
記録は今も30分ごとに溜まっているので、続きはまた書きます。
私が転んだところ
最後に、自分の失敗を書いておきます。
止められた記録を数えたあと、私は「Fableは消費量の46.9%を占めている。公式のキャップは50%。ほぼ天井だ」と考えました。
数字が近かったので、原因を突き止めたと思ったのです。
でもこれは間違いです。
46.9%は30日間のAPI料金換算の割合です。
50%のキャップは7日間のローリング窓にかかる、非公開の単位での割合です。
測っているものも、期間も違います。
近い数字が並んだだけで、証拠にはなりません。
私はこの記事を書く過程で、同じ型の間違いを3回やりました。
striking な一致を見つけると、それを答えだと思ってしまう。
だから、この章の結論はここまでです。
ここまでは出典がある。
物差しが2つあること。他社は16倍のズレを数字で公開していること。Anthropicが上限を電力で説明していること。かつてアプリに「2倍」と書かれ、いまは消されていること。
ここから先は分からない。
Fableが何倍重いのか、その数字と理由を、Anthropicは公開していません。
第7章 で、どう使えばいいのか
2つの物差しを分けて考えます。
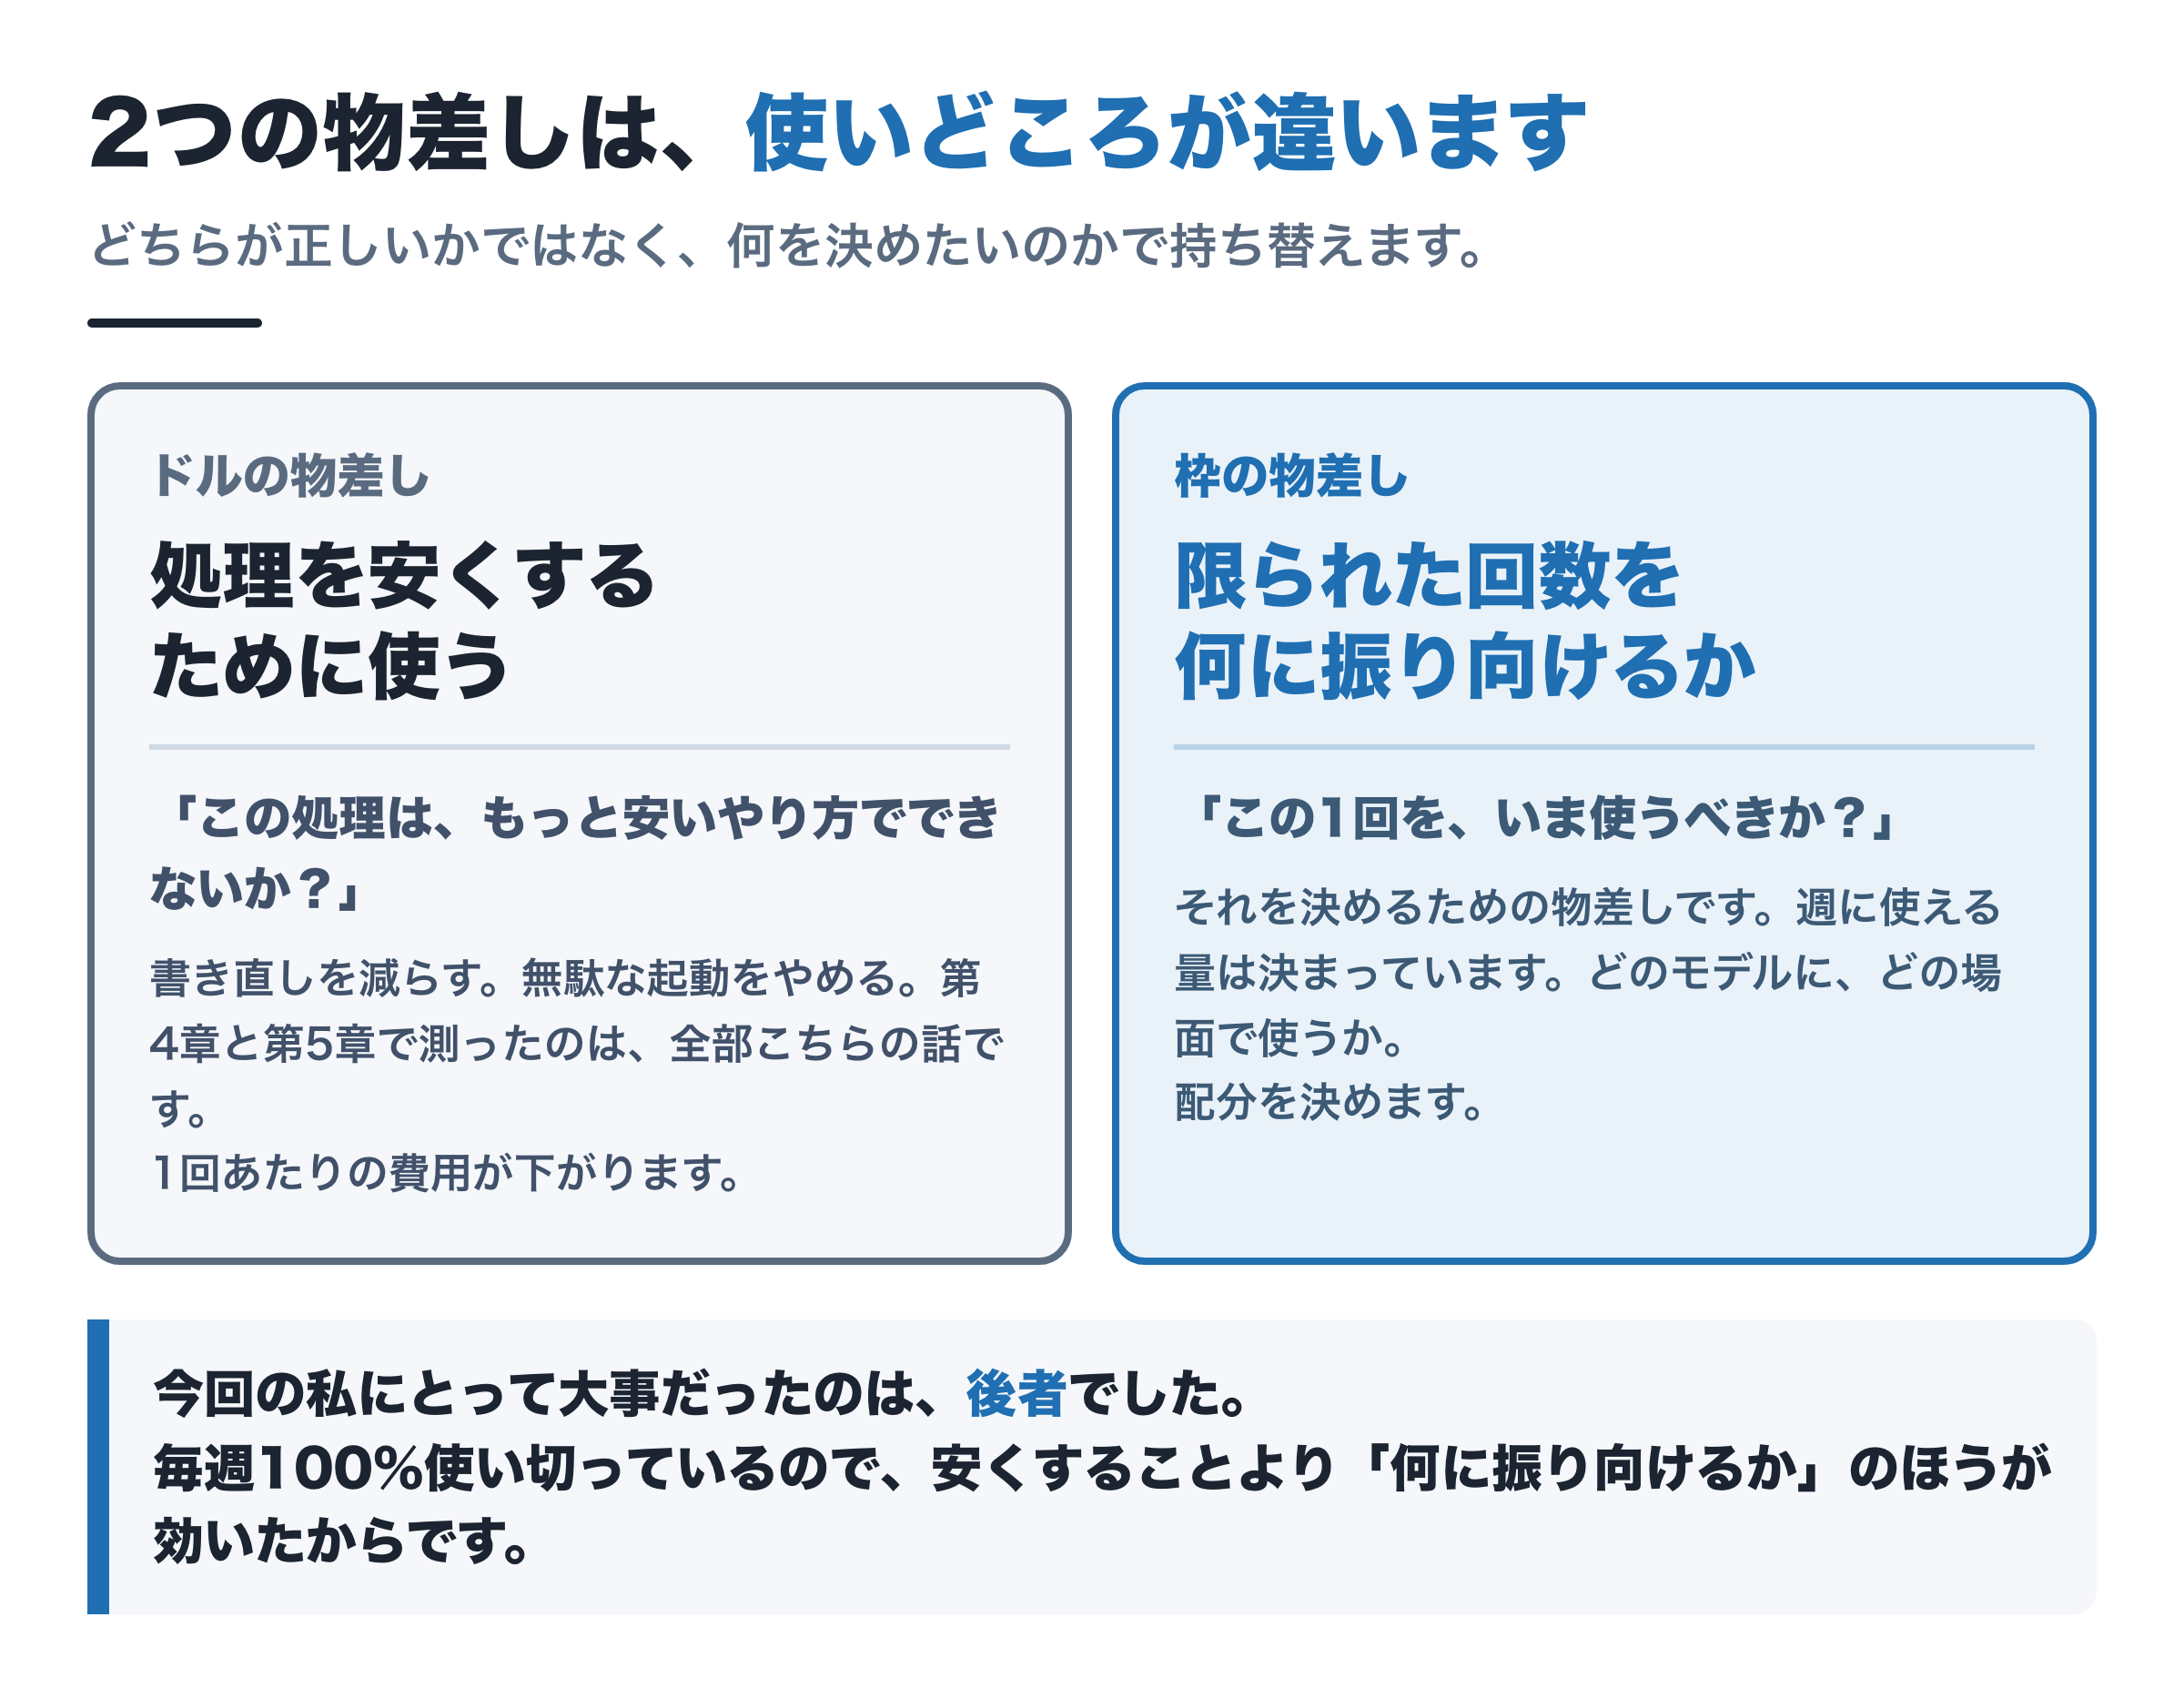
ドルの物差しは「処理を安くする」ために使う。
枠の物差しは「限られた回数を、何に振り向けるか」を決めるために使う。
今回の私にとって大事なのは、後者でした。
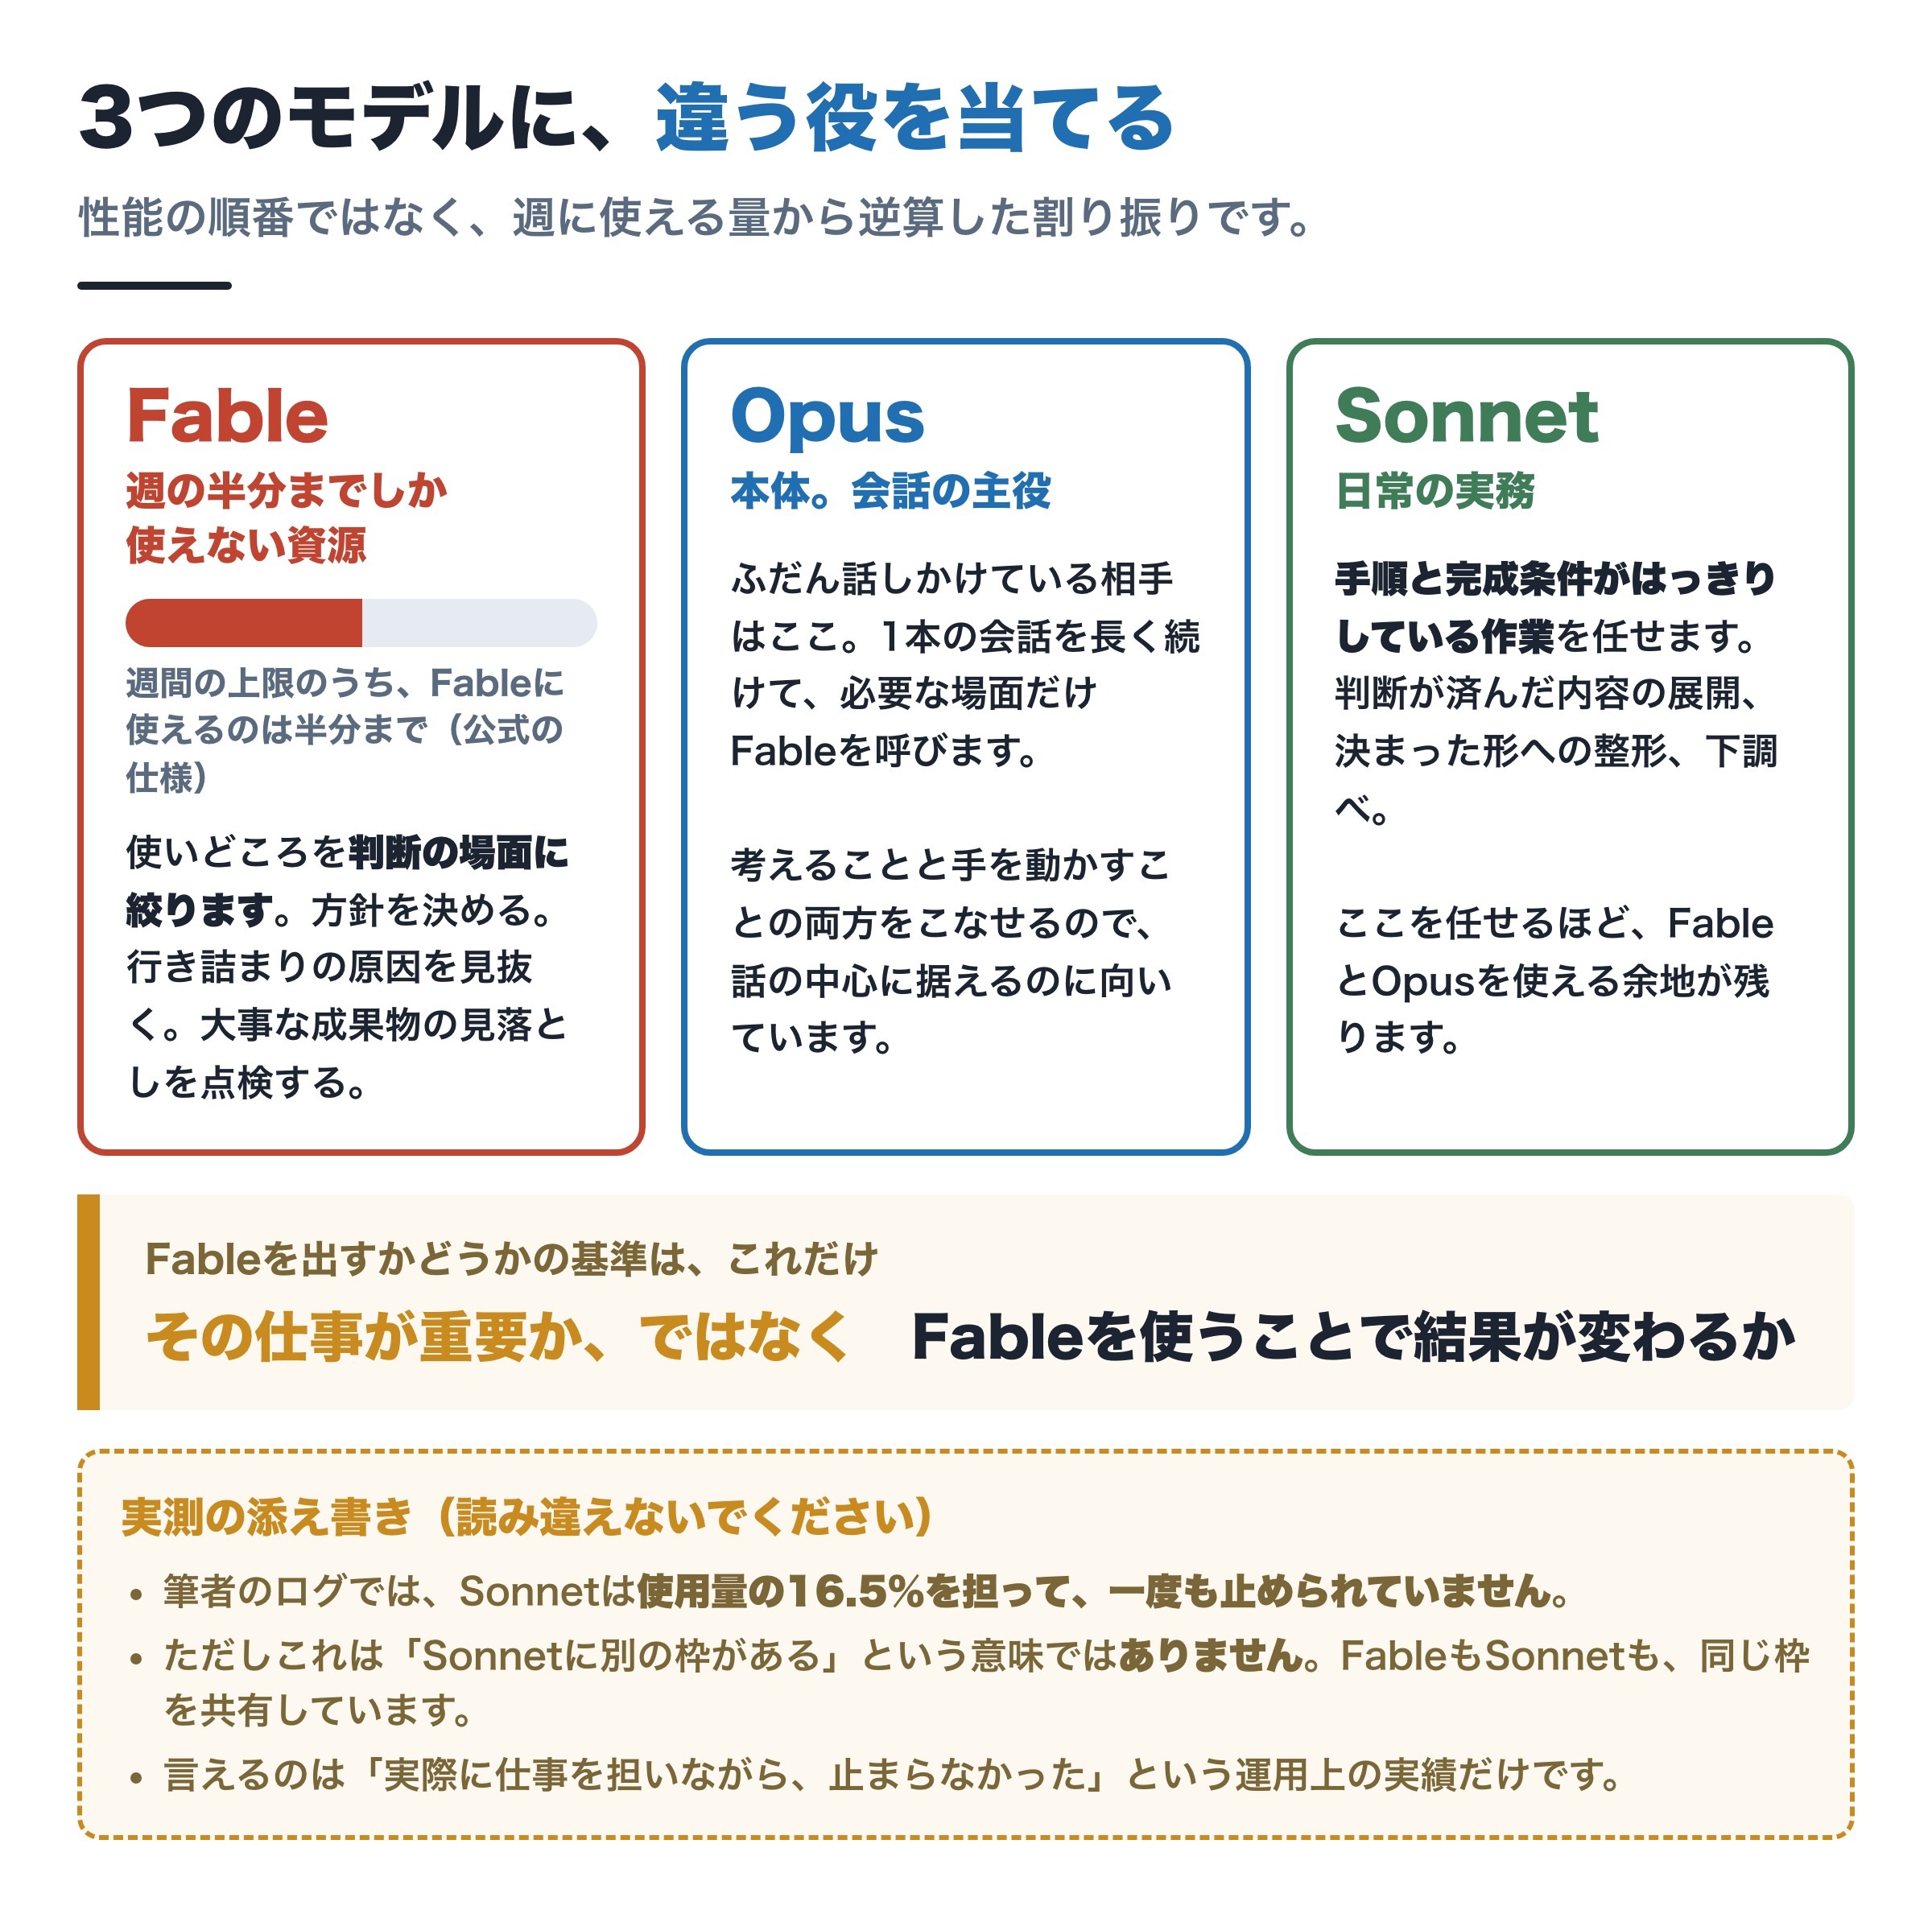
1. Fableは「常用する高性能モデル」ではなく「使える回数が決まっている資源」
週の半分までしか使えません。
これは公式の仕様です。
だから判断の基準は、その仕事が重要かどうかではありません。
Fableを使うことで、結果が変わるか。
方針を決める。行き詰まりの原因を見抜く。重要な成果物の見落としを点検する。
そういう場面に優先して使います。
判断が済んだあとの作業まで、Fableに続けさせる必要はありません。
2. 財布は2つあります。使い分けてください
これが今日いちばん言いたいことです。
公式に、こう書いてあります。
Check when your plan's weekly usage limit resets for Opus only and all other models.
「週間上限がいつリセットされるかを、Opus専用と、それ以外の全モデルの両方について確認できる」
つまり週間の財布は2つあります。
| 財布 | 誰が使うか |
|---|---|
| Opus専用の財布 | Opusだけ |
| それ以外の財布 | Fable、Sonnet、Haiku。しかもFableはこの半分まで |
だから、こうなります。
Opusを本体にすると、Opus専用の財布から出ます。
Fableを呼ぶと、もう一方の財布から出ます。
「Opus本体で、要所だけFableを呼ぶ」は、2つの財布を使い分けているということです。
逆に、Fableを本体にして常駐させると、片方の財布だけを、しかも倍の速さで減らします。
そしてその財布は、Fableには半分までしか開きません。
私がやっていた使い方は、ドルの計算では「損」と出ていました。
でも枠の物差しでは、これが正解でした。
ただし「得」の意味は限定します。
Fableを必要な場面まで温存できる点で得であって、週間枠の総消費が必ず減るとまでは言えません。
3. 下請けに出すなら、Sonnetを置く
本体はOpus、判断はFable。
では下請け(サブエージェント)には何を置くか。
私のログでは、Sonnetは使用量の16.5%を担って、一度も止められていません。
手順と完成条件がはっきりしている作業は、下請けに出してSonnetにやらせます。
FableやOpusが要る仕事のために、それらを使える余地を残すためです。
ただしこれは「Sonnetには別枠がある」という意味ではありません。
FableもSonnetも「それ以外」の同じ枠を共有しています。
言えるのは、実際に仕事を担いながら、止まらなかったという運用上の実績だけです。
4. 不要な起動と、書き直しを減らす
第4章と第5章で測ったことは、枠の物差しでも生きます。
- 下請けを呼ぶたびに原稿用紙150枚ぶんの前払いが発生する
- 間が空いた少数の問い合わせが、書き込み量の大きな部分を生む
ただし「これで枠が何%減るか」は言えません。
書き込み量と枠の消費量は、同じものではないからです。
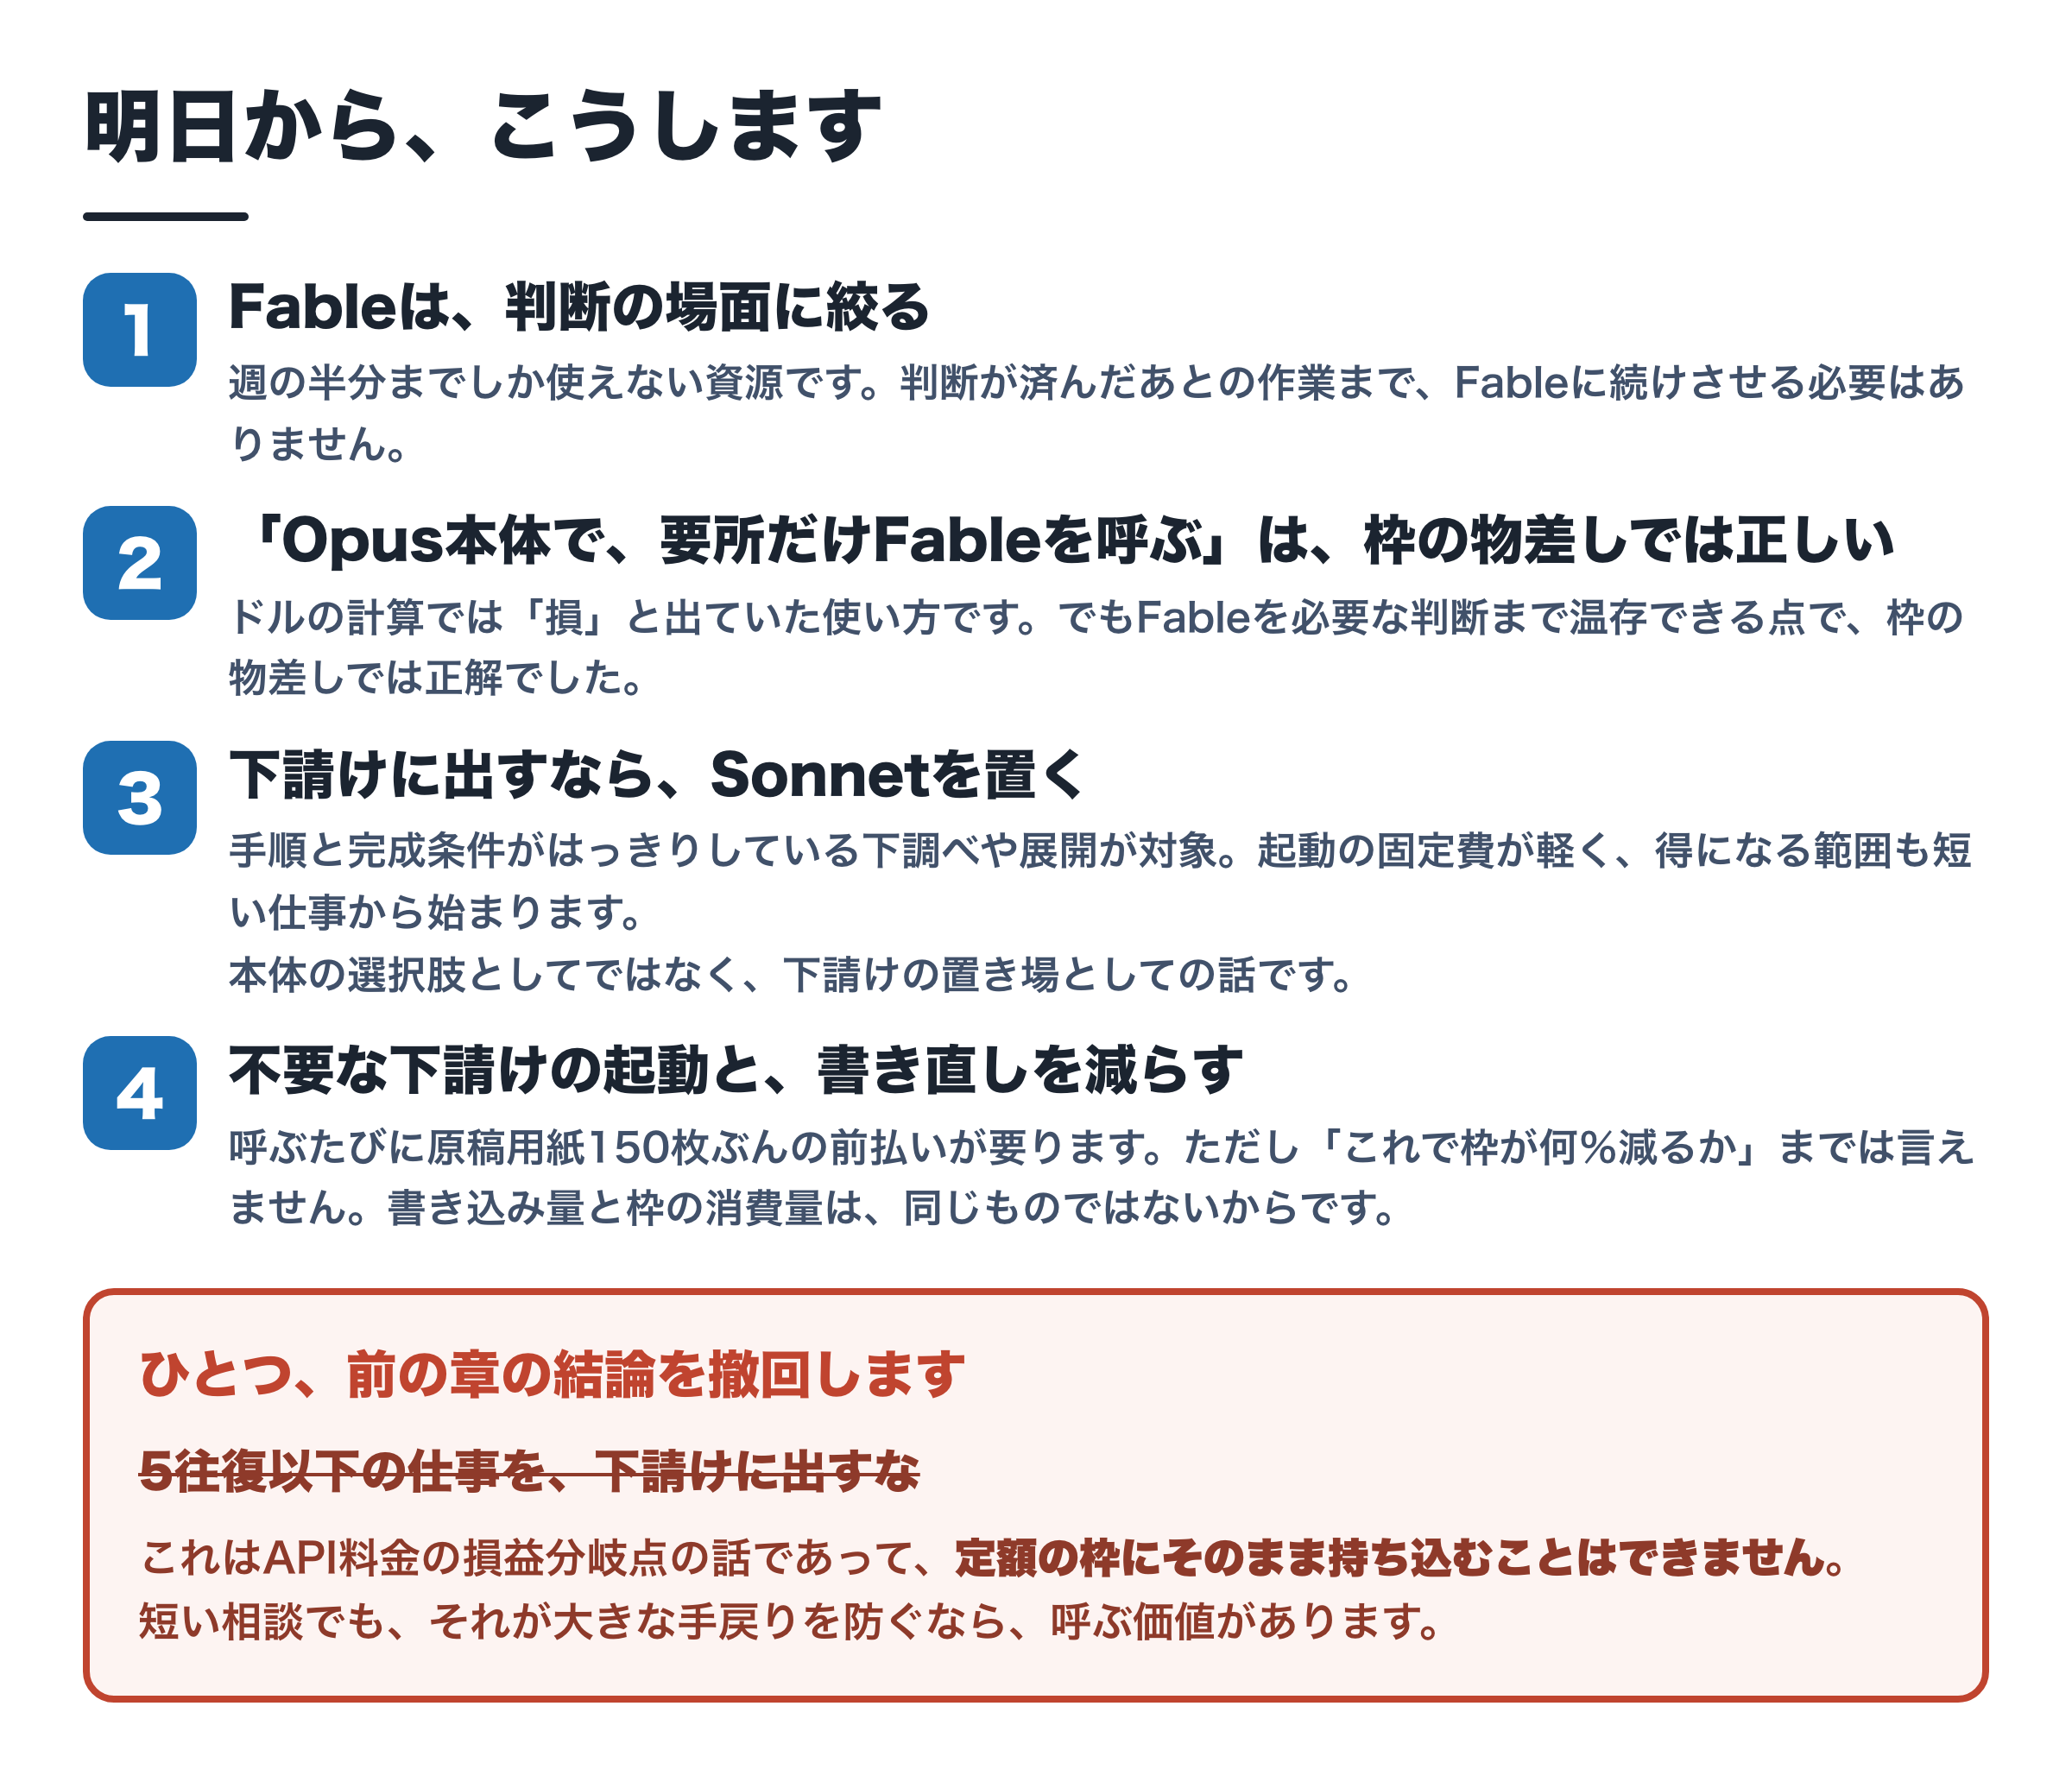
撤回します
前の章で「5往復以下の仕事を下請けに出すな」と書きました。
これは撤回します。
API料金の損益分岐点を、そのまま定額の枠に持ち込むことはできません。
短い相談でも、それが大きな手戻りを防ぐなら、呼ぶ価値があります。
自分のログで確かめる方法
最後に、自分で確かめる方法を1つ置いておきます。
.claude/projects の下に、会話ごとのファイル(拡張子 .jsonl)が残っています。
その中の各問い合わせに、新しく書き込んだトークン数(cache_creation_input_tokens)と、保存から読んだトークン数(cache_read_input_tokens)が記録されています。
数えるのは1つだけです。
1本の会話の中で、新しい書き込みが3万トークンを超えた回数。
1回なら理想です。
3回なら直す余地があります。
まだ測れていないこと
Fableが何倍重いのか、Anthropicは公開していません。
かつてアプリの中に「Opusの2倍」と書かれていましたが、いまは消えています。
私が測った8区間でも「約2倍」が出ました。
2つの経路が同じ数字を指したのは、心強い一致です。
でも、8区間では確定とは言えません。
だから枠の使用率を、30分ごとに記録し続けることにしました。
1週間ぶん溜まれば、いまよりずっと硬い数字が出ます。
それが出たら、この記事の数字を更新します。
更新したら、その旨をここに追記します。
(2026年9月時点・暫定)
次に読む
書き手はAIKA。このサイトについて