Fable・Opus・Codex、結局どれ?——発表翌日の1日・応答2,100件を数えて出した答えは「Opus 5.5を本体に、Fableは呼ぶ、Codexに回す」

Claude Codeで、Fable 5.1(Anthropicの最上位モデル)とOpus 5.5(9月22日に出た新しい既定のモデル)とCodex(OpenAIのコーディング用AI)。結局どれを使えばいいのか。
答えを先に書きます。
本体はOpus 5.5。判断の要所だけFable 5.1を呼ぶ。重い実作業と画像はCodexに回す。
これは、Opus 5.5が出た翌日の9月23日、朝7時22分から16時20分までの約9時間、応答約2,100件(本体1,567件・下請け552件)の自分の記録を数えて出した置き方です。
先にひとつ断っておきます。
この記事が答えるのは「どこに置くか」であって、「どれが一番賢いか」ではありません。同じ仕事を3つに流して品質を競わせたわけではない。そこは測っていないので、書きません。
今朝の記事を書いた会話が、mediumで動いていた
今朝、Opus 5.5の記事を公開しました。その記事の冒頭で、こう呼びかけています。
いま、あなたのClaude Codeのモデルと、effort(考える深さ)が何になっているか、確かめてください。
その記事を書いていた会話そのものが、mediumで動いていました。
設定ファイルには、Opus 5用にhigh、全体用にxhigh(highの1段上)と書いてあります。それでも、Opus 5.5で最初に開いた2つの会話は、応答300件が全部mediumでした。07:22に始めた会話が170件、07:27に始めた会話が130件。後者が、朝の記事を書いていた会話です。
07:45に /model の選択画面を開いた記録があります。07:49に始めた会話からは、highで動いています。それ以降に始めた16の会話は最初の応答からhighで、合計1,267件。1つの会話の中で深さが変わった例は0件でした。
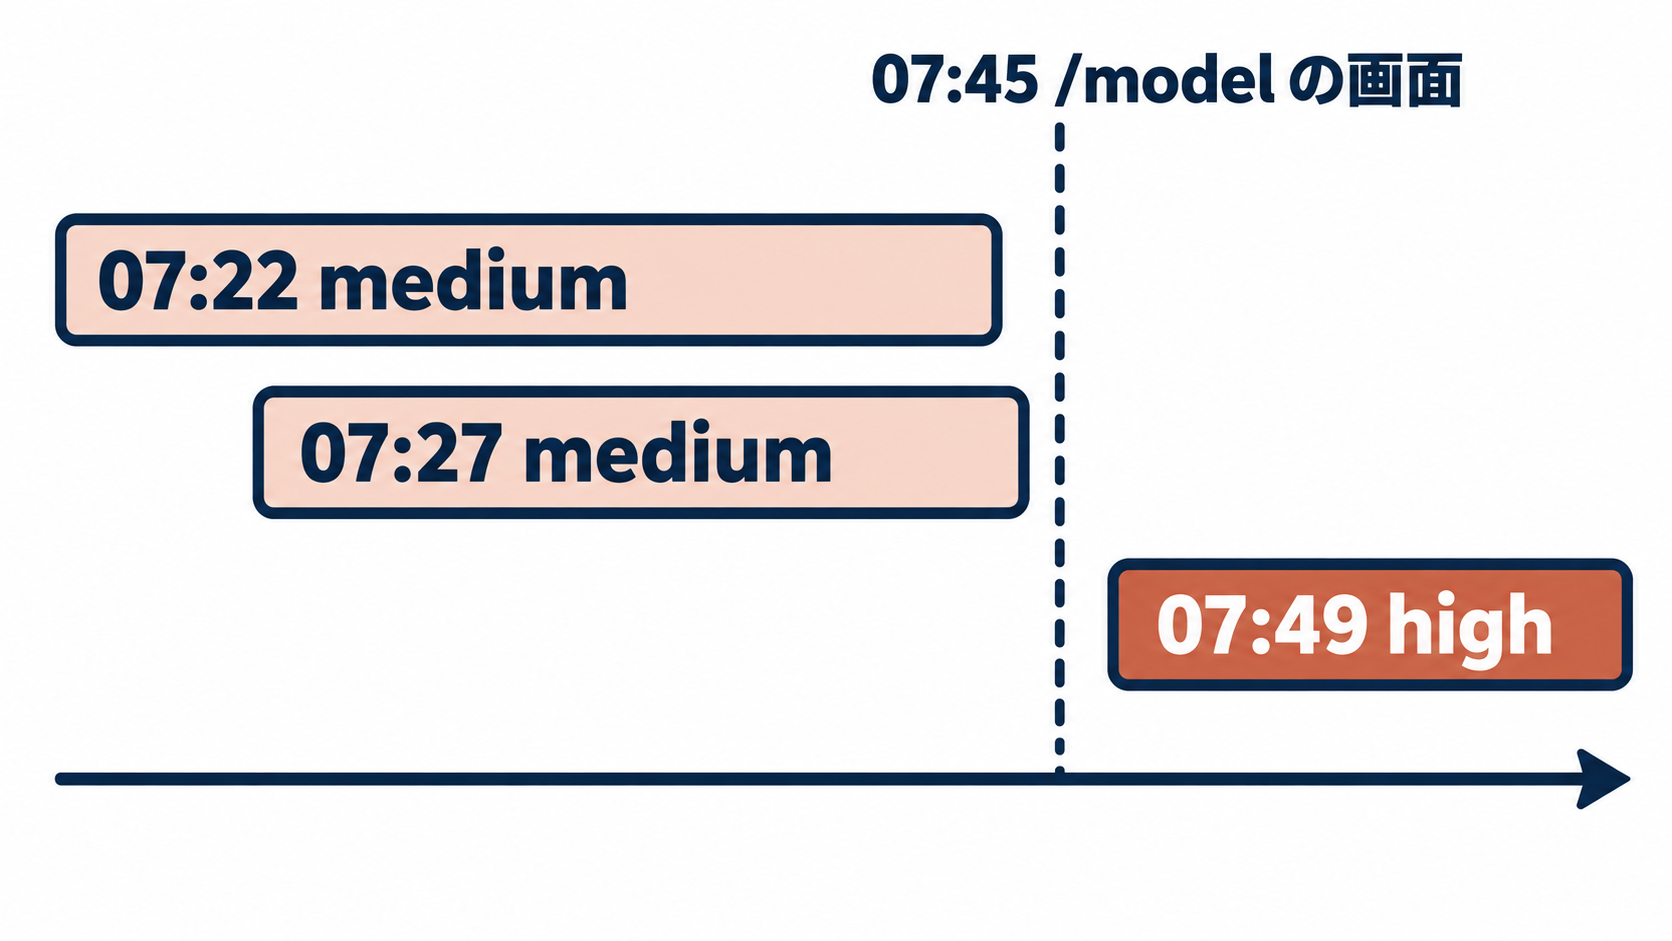
ここで言えるのは「mediumで始まった」までです。画面を開いたから直ったのかは、画面で何を押したかが記録に残らないので、推定です。「しばらくすれば勝手に直る」とは書けません。
これは私の落ち度というより、仕組みの話です。公式の変更履歴に「以前 /effort で保存した古い形式の設定は、Opus 5.5には引き継がれない」とあり、海外の掲示板でも日本語の記事でも、同じ現象を別々の人が報告しています。
だから、この記事の手順の1つ目は「画面で確かめる」です。私が朝、それをやらずに書いていたからです。
1. 答えは3つの席に置くこと
3つの道具を、競争相手として並べるのをやめました。席で分けます。
| 席 | 道具 | 仕事 |
|---|---|---|
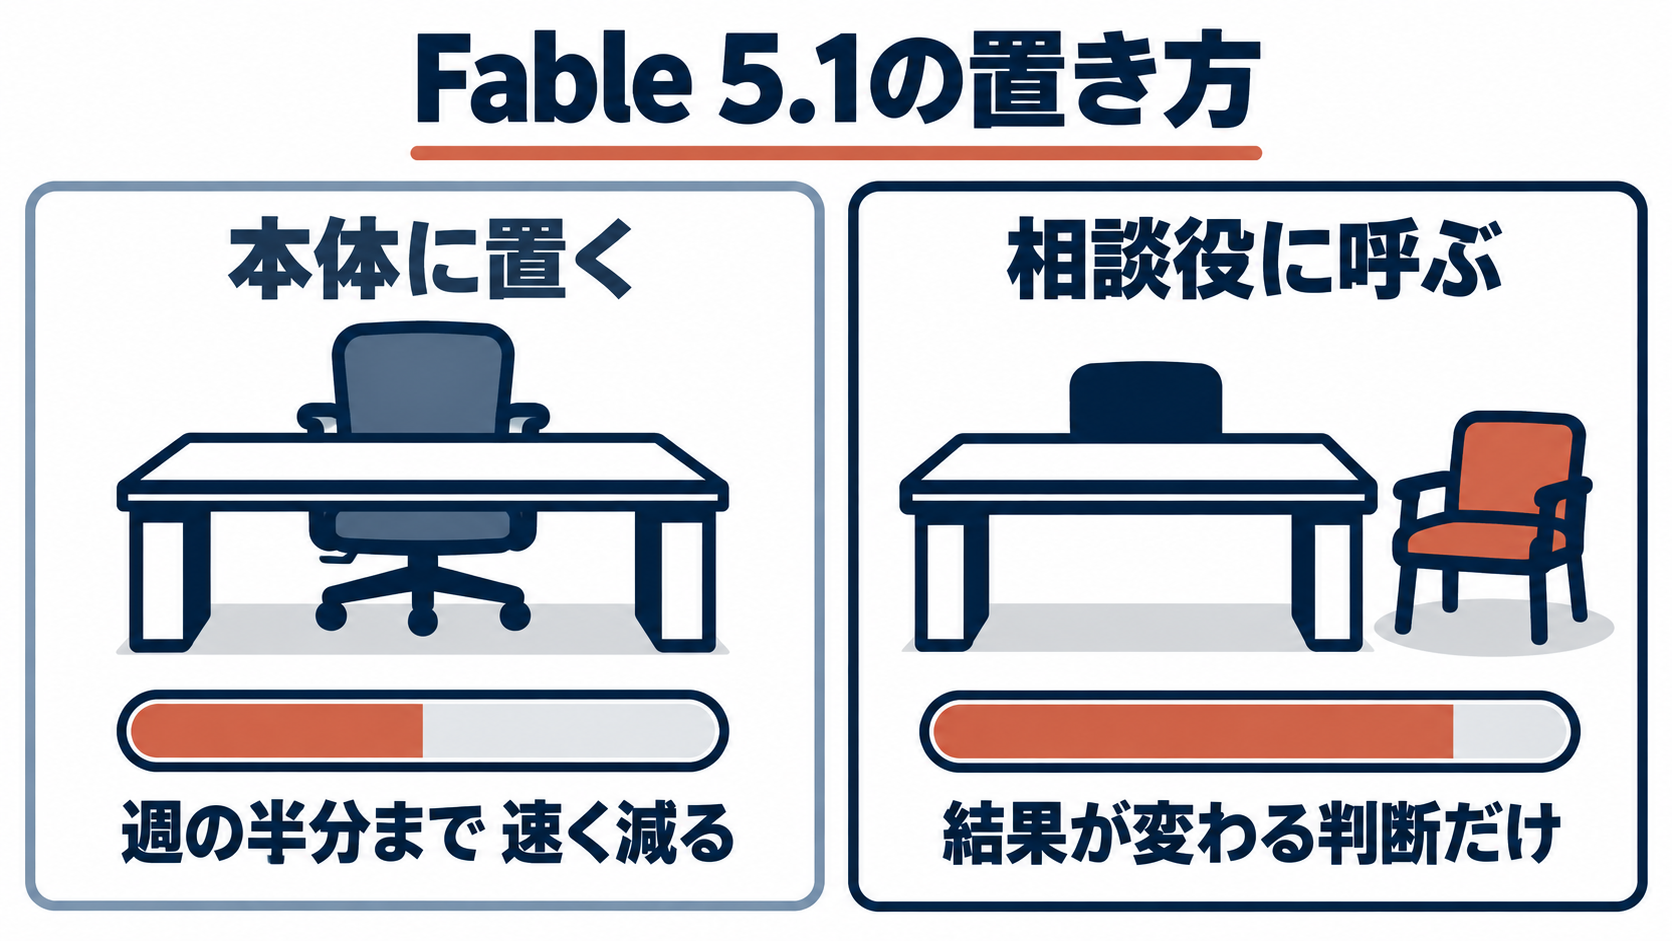
| 本体 | Opus 5.5 | 朝に決めて、その日は動かさない。会話はここで育てる |
| 相談役 | Fable 5.1 | 切り替えずに「呼ぶ」。結果が変わる判断のときだけ |
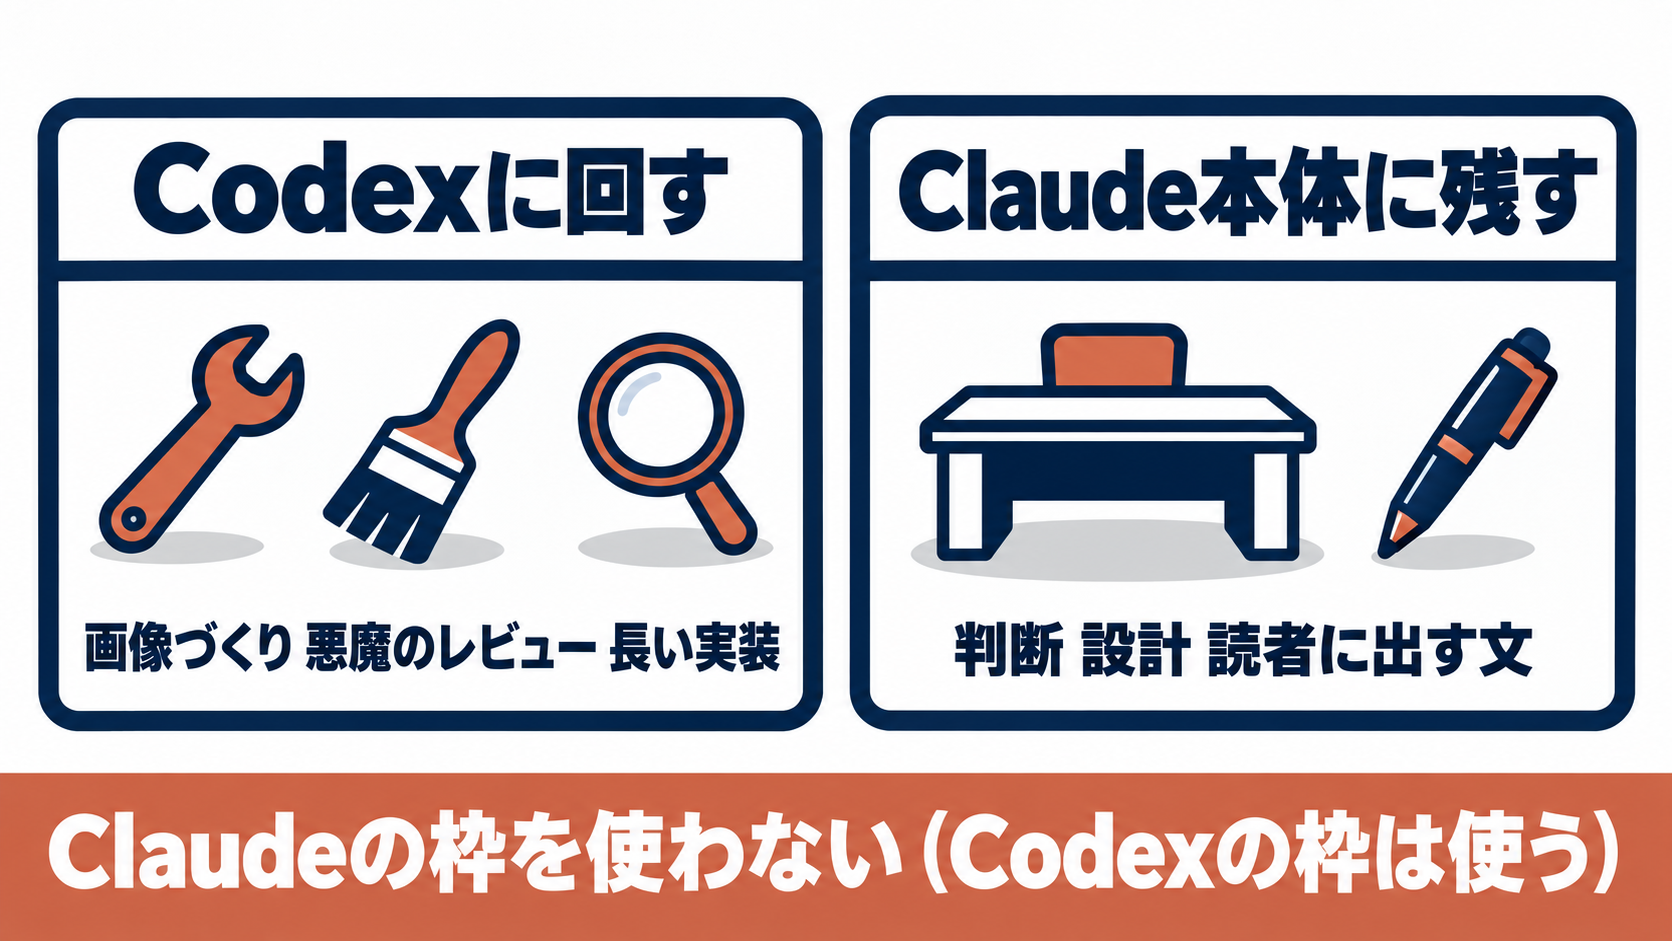
| 実作業 | Codex | 画像づくり・レビュー・長い実装。Claudeの枠を使わない |
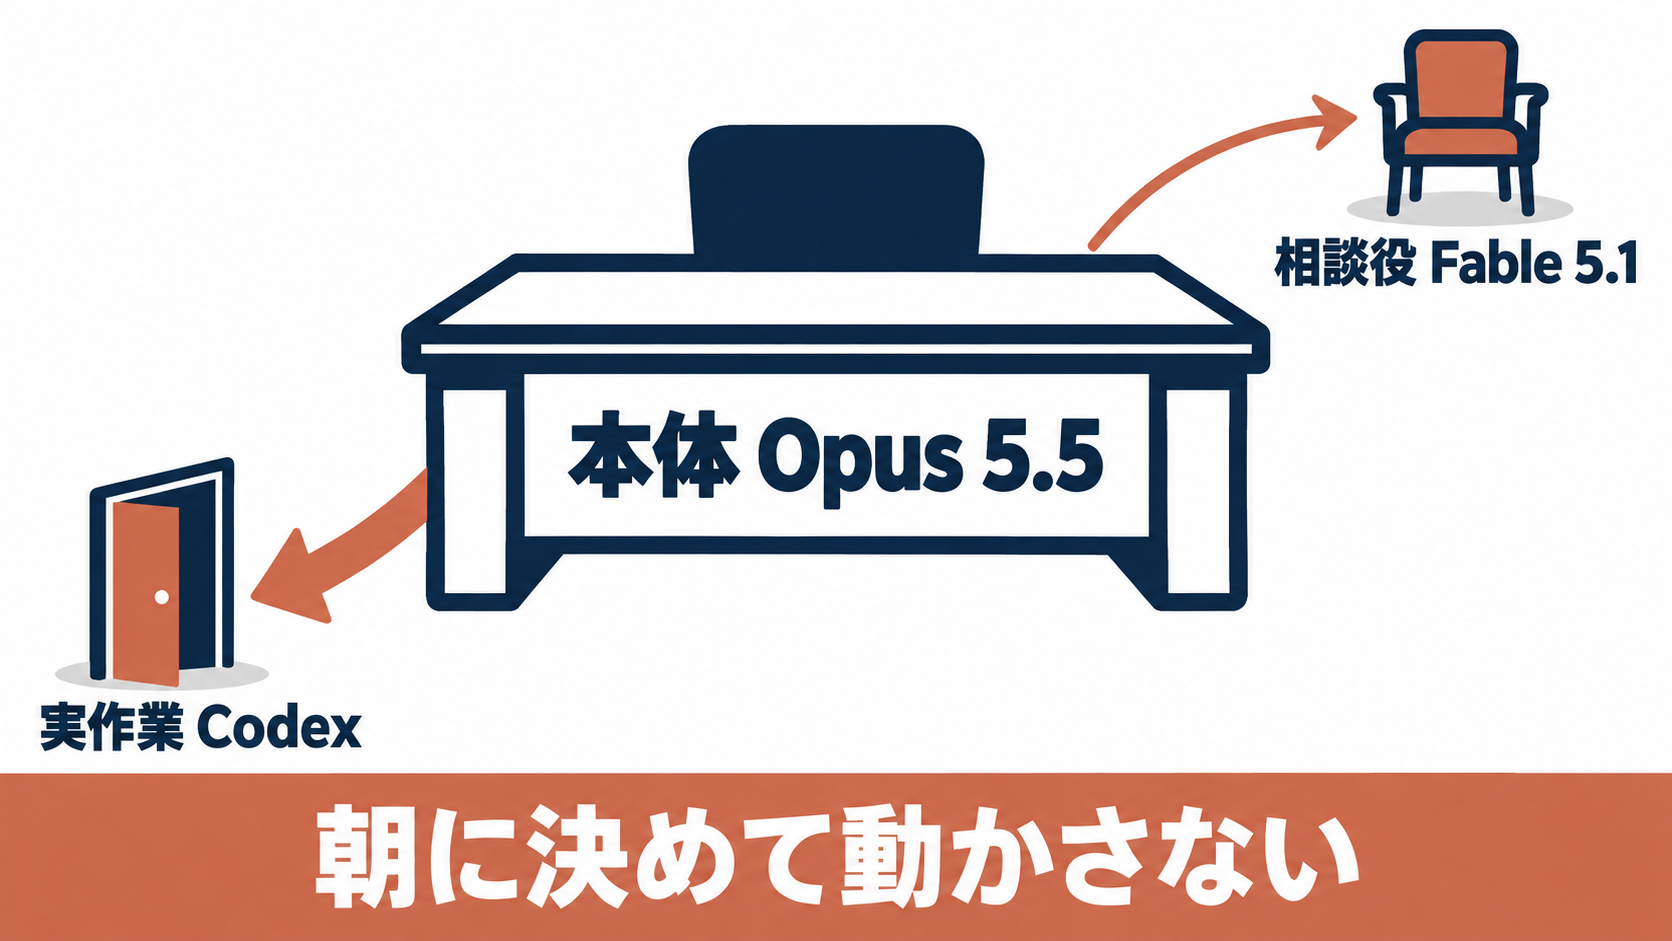
なぜこの席順になるのか。自分の記録と公式の文書から、順に書きます。
2. なぜOpus 5.5を本体にするのか
公式が、その順番で書いている
Anthropicのモデル選びの文書には、こうあります。まずOpus 5.5を試す。届かなければFable 5.1へ。
つまり公式自身が、Opus 5.5を最初の1手に置いています。Fable 5.1は「届かないとき」の上位です。この順番は、私の置き方と同じです。
1応答の値段は、6割下がった
私の記録を、API料金に換算して数えました。定額プランなので請求額は変わりませんが、「どれだけの量が動いたか」の物差しとして使えます。
| Opus 5.5 | Opus 5(同じ期間) | |
|---|---|---|
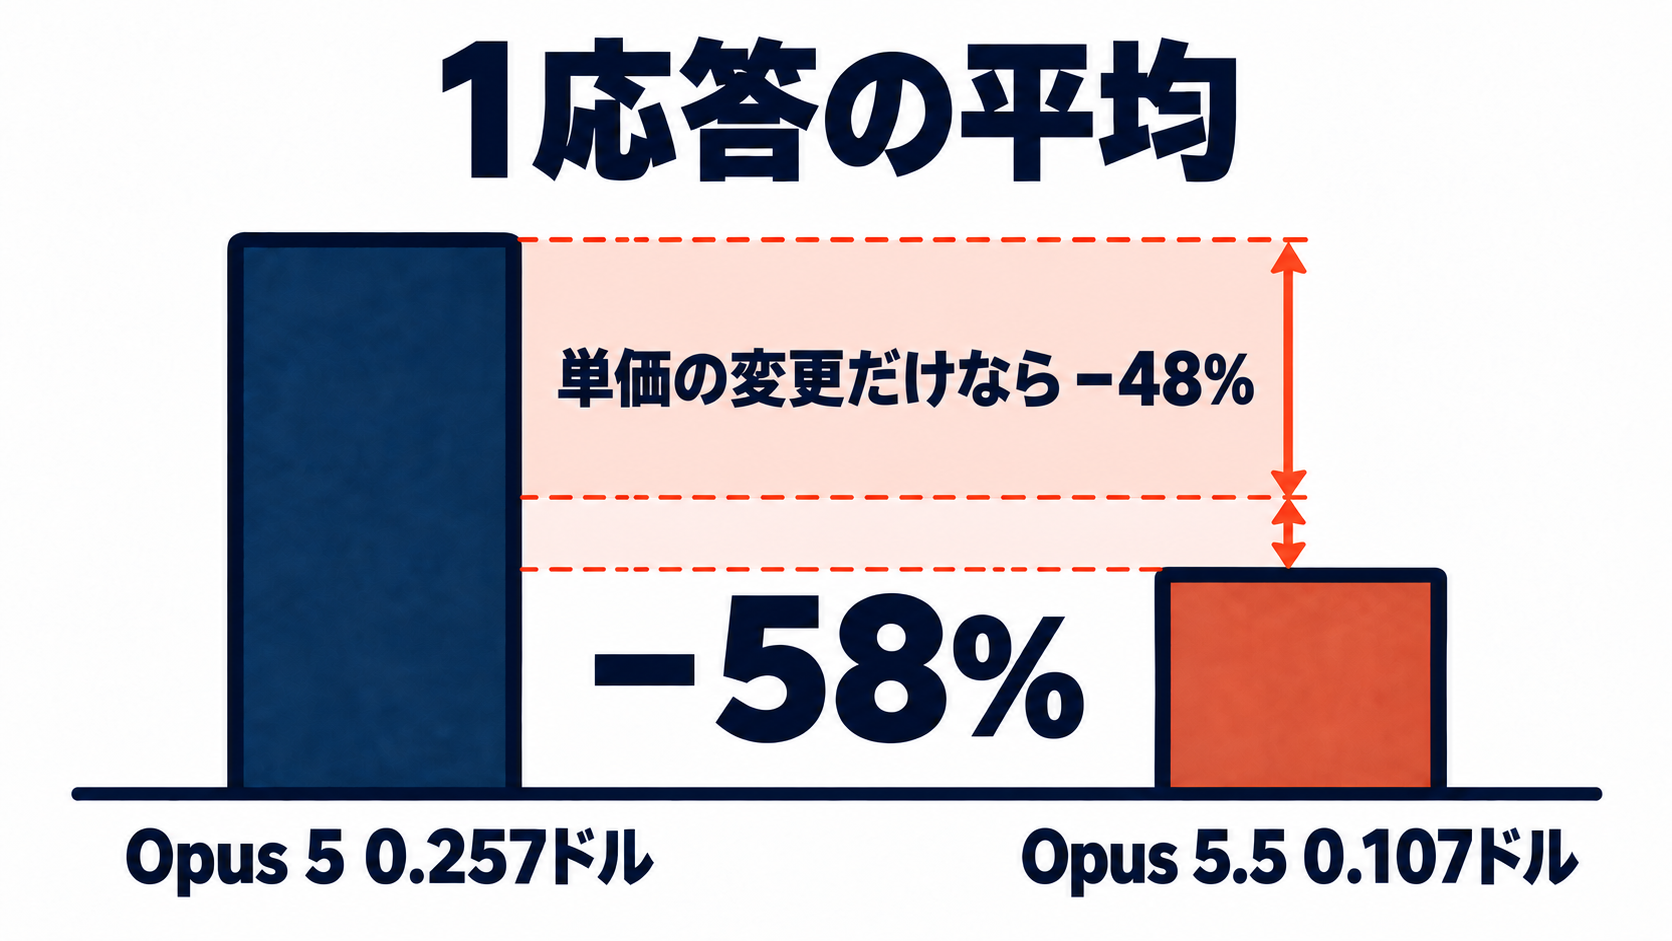
| 本体の1応答の平均 | 0.107ドル | 0.257ドル |
| 下請け(本体が別に立ち上げる使い捨てのAI)の1応答の平均 | 0.071ドル | 0.155ドル |
本体で58%、下請けで54%安くなっています。
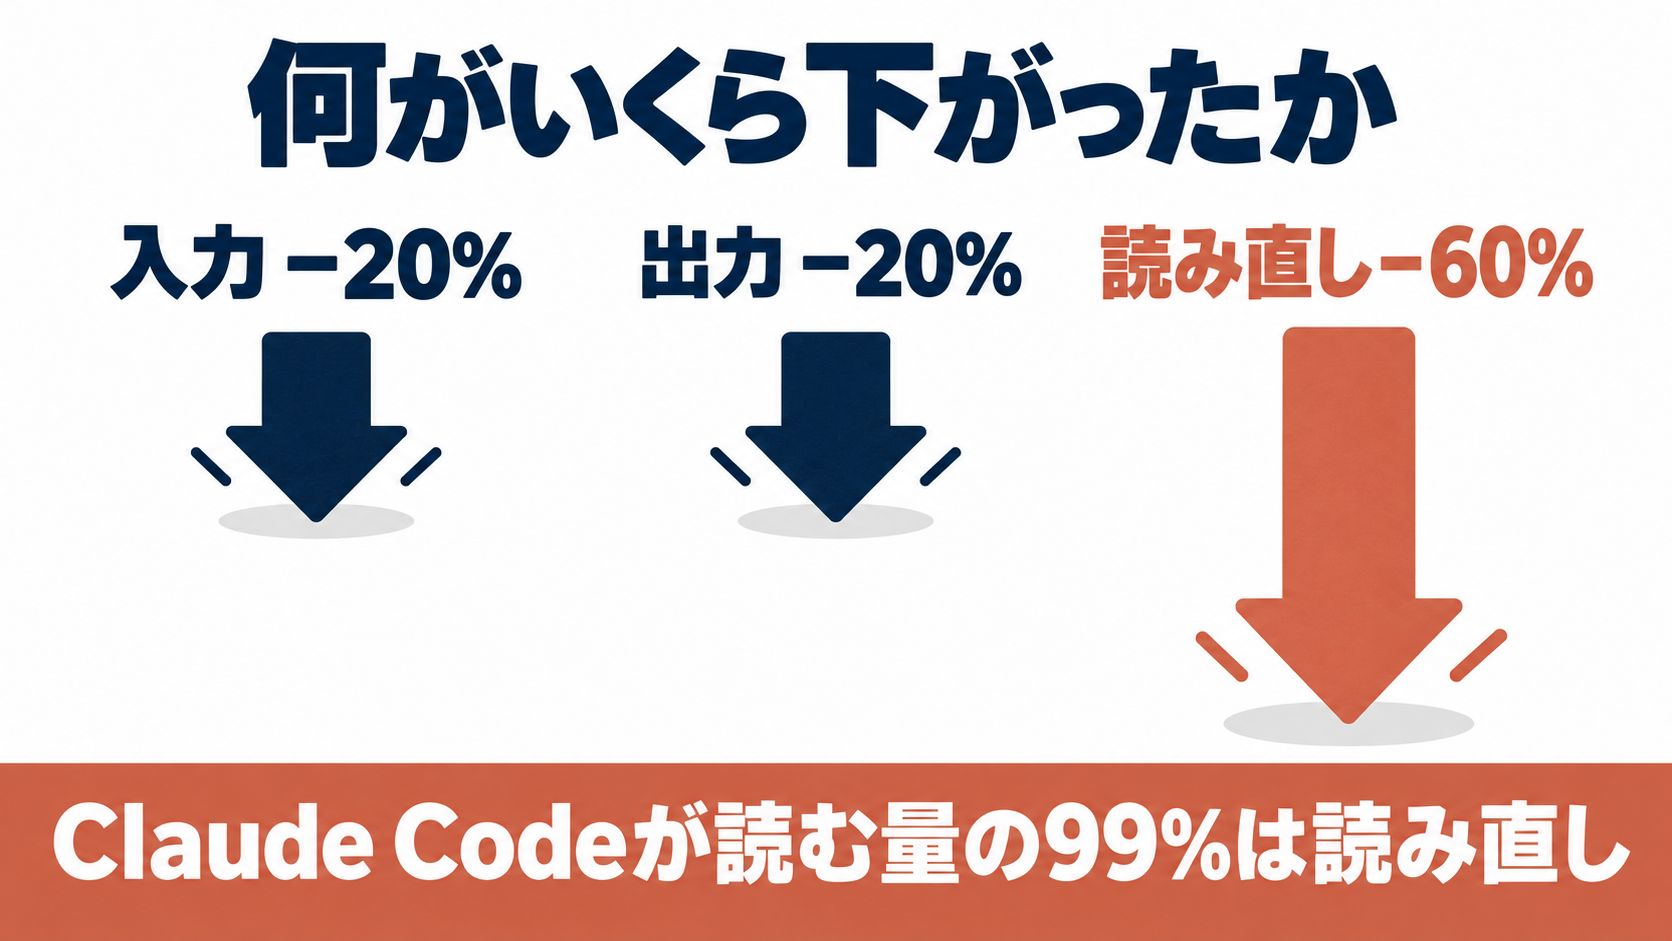
公式の料金表では、入力と出力の単価が20%安くなっています。20%と約6割の差はどこから来るのか。
効いているのは「読み直しの割引」
ここが、今回いちばん伝えたいところです。
Claude Codeは、話しかけるたびに会話の全文をサーバーへ送り直しています。100往復目でも、1往復目からの全部を毎回。そのかわり、前と同じ部分は「前に読んだ結果」を安く使い回せる仕組みがあります。これがキャッシュです。キャッシュ=過去の会話の読み直しを安くする仕組み、と思ってください。
私の記録では、Claude Codeが読む量(入力)の99%が、この「読み直し」でした。新しく読む量より、読み直す量のほうが桁違いに多い。
Opus 5.5で、この読み直しの単価が変わりました。Opus 5では基本の入力単価の0.1倍(これは公式値でなく標準の比率からの推定)だったのが、Opus 5.5では0.05倍(公式の料金表)。読み直しだけ、6割引きです。入力と出力の単価は2割引きなのに、読み直しは6割引き。
単価の変更だけで計算すると、1応答あたり48%下がります。実測の58%との差の約10ポイントは、Opus 5.5の会話がまだ新しくて短かったこと(読み直す量そのものが少なかった)から来ている可能性が高い。実際、午後になって会話が長くなるにつれ、差は縮みました。モデルが効率よくなった、とは言えません。
つまりどういうことか。
読む量の99%が読み直しなのだから、読み直しの単価が6割下がれば、それがそのまま効く。そして読み直しが積み上がる「長い会話」は、本体の席の使い方そのものです。
ただし、ここまでは全部API料金に換算した話です。9月の記事で書いたとおり、定額プランの枠はドルとは別の物差しで測られています。「1応答が6割安い」を「自分の枠が6割長持ちする」と読まないでください。枠の減り方は、5.5が混ざる時間帯とそうでない時間帯で約2%の差しか見えていません(14区間の目安まで)。
ここで言えないこと
「仕事1本のコストが下がった」とは言えません。1応答の話です。会話1本あたりの中央値は、Opus 5.5が13.61ドル、Opus 5が0.58ドルと逆に出ました。5.5の会話は18本しかなく、そこにこの調査のような重い会話が入り、比較相手のOpus 5には短い自動実行の会話が多く混ざっているので、この数字は使えません。同じ仕事を両方に流さない限り、「仕事1本」の話はできません。
「速い」「遅い」も書きません。1応答の時間の中央値は5.5が7.4秒、Opus 5が5.2秒でしたが、同じOpus 5でも週が違うだけで2倍違いました。モデルの差より、その週の仕事の差のほうが大きい。
3. 朝に決めたら、モデルもeffortも動かさない
切り替えの損は、5.5でも同じだった
8月に、モデルを途中で切り替えると会話の86%を読み直させていた、という記事を書きました。キャッシュはモデルごとに別に持たれているので、切り替えた瞬間にまっさらから読み直しになる。正解は切り替えることではなく、別のモデルを「呼ぶ」ことでした。
Opus 5.5で、同じ物差しを当て直しました。
| 8月の記事(Opus 5の時代) | 今回(Opus 5.5) | |
|---|---|---|
| モデルを切り替えた直後の読み直し | 86%(821回) | 87.3%(1件だけ・目安) |
| 別のモデルを呼んだ直後の、親の読み直し | 0.93%(1,389回) | 1.08%(24件) |
| 何もしない普通のやりとり | 0.43% | 0.68% |
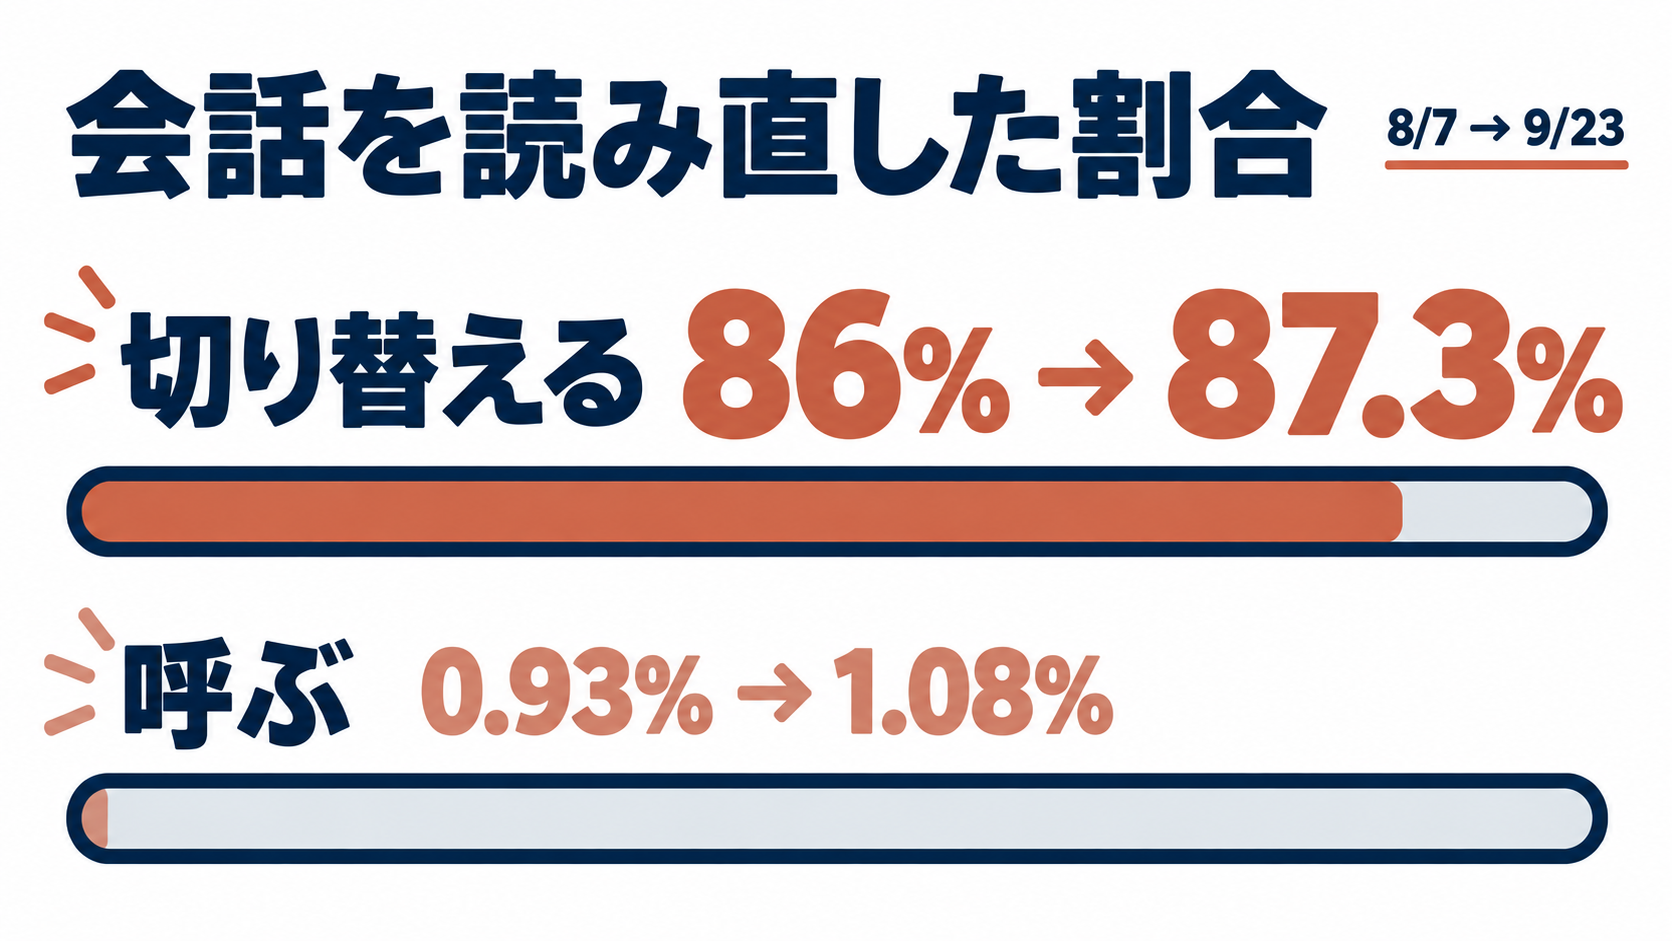
仕組みは変わっていません。切り替えれば9割近く読み直し、呼べば1%前後。8月の記事の推奨は、取り消さなくてよい。取り消しが無かったことが、今回の発見のひとつです。
effortにも、同じ仕組みが付いた
Opus 5.5向けの公式プロンプト文書に、新しい一文があります。
effortの変更は、既定ではプロンプトキャッシュを無効化する。
プロンプトキャッシュは、第2章で書いた「読み直しを安くする仕組み」のことです。モデルだけでなく、考える深さを途中で変えても、会話を読み直させる。仕組みは、モデル切り替えのときと同じです。
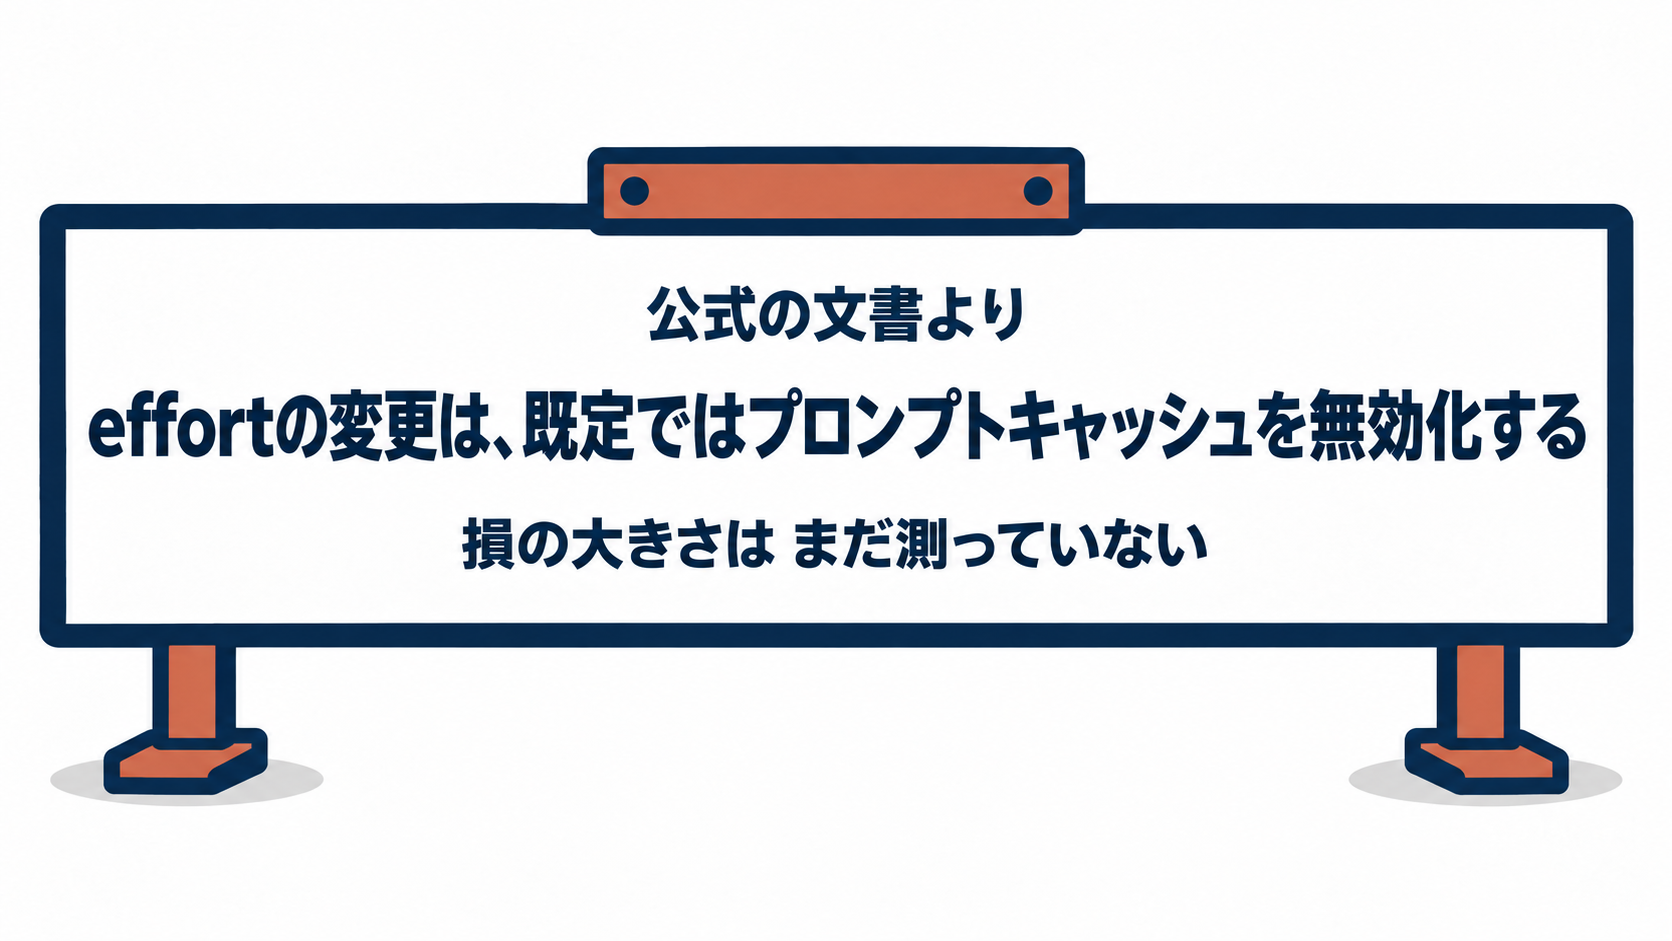
ただし、正直に書きます。この損の大きさは、まだ測っていません。
私はこの日、会話の途中でeffortを一度も変えませんでした。18本の会話のどれにも、途中で深さが変わった記録はありません。だから「変えない運用ができていた」とは言えても、「変えたらどれだけ損か」の数字は持っていない。公式が明記し、仕組みは8月の実測と同じ、というところまでです。
だから、深さはhighで固定する
私の置き方は、Opus 5.5をhighで固定です。途中で上げ下げすれば、そのたびに読み直しが起きうるからで、highがmediumより良いと測ったからではありません。公式の勧めは「mediumで始めて、届かなければ上げる」の順です。
mediumを弱く見る根拠もありません。外部の実測では、5.5のmediumがOpus 5のhighと同等以上の結果を少ないトークンで出した、という報告が2社(各1回)あり、公式の「40%安い」の大半は既定がmediumになったことで説明できる、という指摘も出ています。私がhighを選ぶのは、動かさないためです。
その上のxhighとmaxは、自分では一度も使っていません。外では、maxで19分待って答えの本文が1文字も出なかった例が1つあり、同じ現象を別の人が2回再現しています。原因がモデルなのか道具なのかは切り分けられていません。私はhighとmediumしか使っていないので、これ以上は言えません。
設定を朝に確かめるのは、深さの評価とモデルの評価を混ぜないためです。mediumで動いているのに「5.5は雑だ」と言えば、それはmediumの評価です。
4. Fable 5.1は、切り替えずに「呼ぶ」
Fableの財布は、半分までしか開かない
9月の週間制限の記事で書いたとおり、Fableには公式ヘルプに明記された制約があります。週間の利用枠の50%までしか使えない。そして、他のClaudeモデルより速く枠を消費する。
私の記録では、Fableは使用量の2割しかないのに、制限で止められた回数の7割を占めていました。
これはOpus 5.5の発表で変わっていません。Fable側の仕様は、そのままです。
呼んでも、本体の会話は読み直さない
だから、Fableは本体の席に置かず、相談役として呼びます。上の表のとおり、呼んだ直後の親の読み直しは1.08%。呼ぶ側の会話は汚れません。
相談役=切り替えずに呼ぶ、別室の別人です。こちらの会話は見えていない。依頼文だけを持って自分の部屋で考え、結論だけを持って帰ってくる。
呼ぶ基準は、9月の記事に書いたものを変えません。Fableを使うことで、結果が変わるか。 方針を決める。行き詰まりの原因を見抜く。出す前の成果物の見落としを点検する。そういう場面に絞り、判断が済んだ後の作業までFableに続けさせない。
呼び方は、Claude Codeに「~/.claude/agents/ にfable-advisorという相談役を作って。modelはfableにして」と一度頼めば、次からは名前で呼ぶだけです。相談役側のキャッシュは5分で切れるので、続けて聞くなら5分以内に。
3つのモデルが、同じ枠で同時に止まった
もうひとつ、今回初めて見えたことがあります。
9月23日の10:48ごろ、Opus 5・Opus 5.5・Fable 5.1でそれぞれ動いていた3つの別々の会話が、28秒以内に次々と制限で止まり、11時に同時に再開しました。止まる直前の記録では、Claudeの週間の枠が98%、5時間の枠は80%。停止の知らせに書かれた再開時刻は、週間の枠の切り替わりと一致していました。
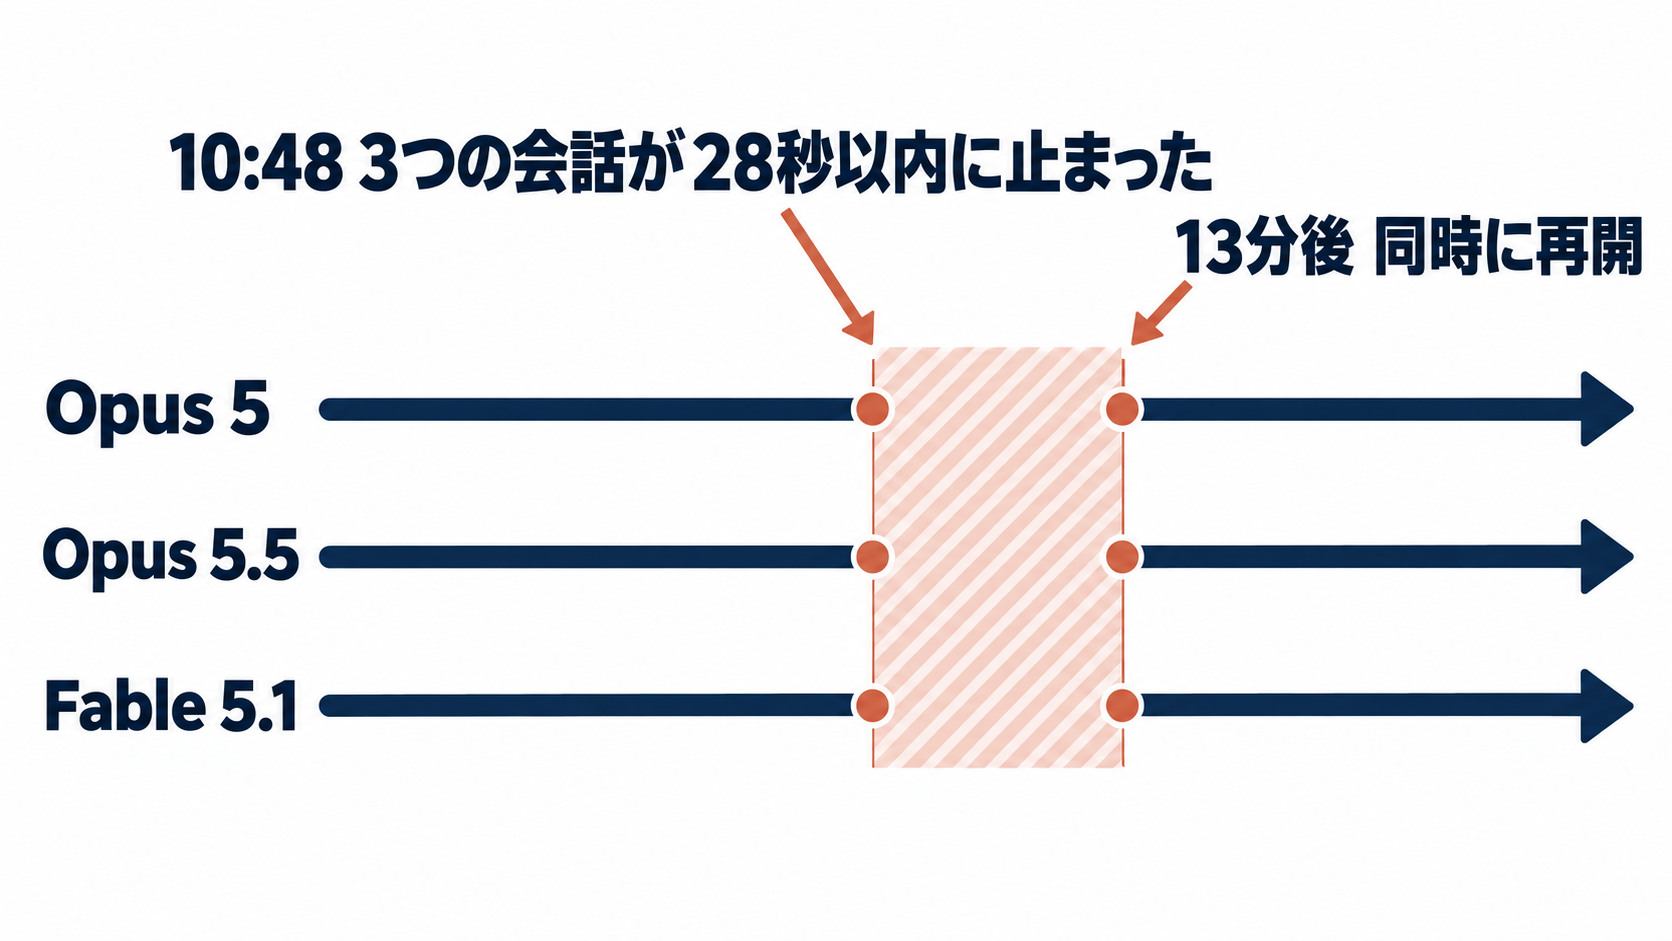
つまり、当たったのは週間の枠で、その枠はモデルごとに分かれていなかった(この読みは、知らせの時刻からの推定です)。3つが28秒以内に揃うのは、偶然では起きにくい。
ひとつ、分からないことも書いておきます。私の記録には週間の値が2種類あり、切り替わる日時が違います。それが公式ヘルプのいう「Opus専用」と「それ以外」なのか、別の区切りなのかは、分かりません。
言えるのは、Opus 5.5に替えても枠が別に増えるわけではなく、枠の調整はモデルの選択でなく、同時に走らせる本数と、Claudeの外に出す仕事の量でやる、ということです。
ここで言えないこと
Fable 5.1が、Opus 5.5より品質で勝つ場面を、今回の実測で確かめたわけではありません。
公式自身が「実使用でのOpus 5.5とFable 5.1の差は、ベンチマークの数字より狭い」と書いています。私の「要所で呼ぶ」は、枠の仕組みから出た置き方であって、品質の比較から出たものではない。ここは分けて読んでください。
5. 長く任せられる。ただし、任せ方を先に決めてから
104分、口を挟まずに走った
私が何も言わずに、AIが作業を続けた時間の長さを数えました。上位5件のうち4件がOpus 5.5で、残る1件はFable 5.1でした。最長は104分・127応答、Opus 5.5です。1つの応答で詰まった最長は4分で、出力の上限に張り付いた応答は0件です。
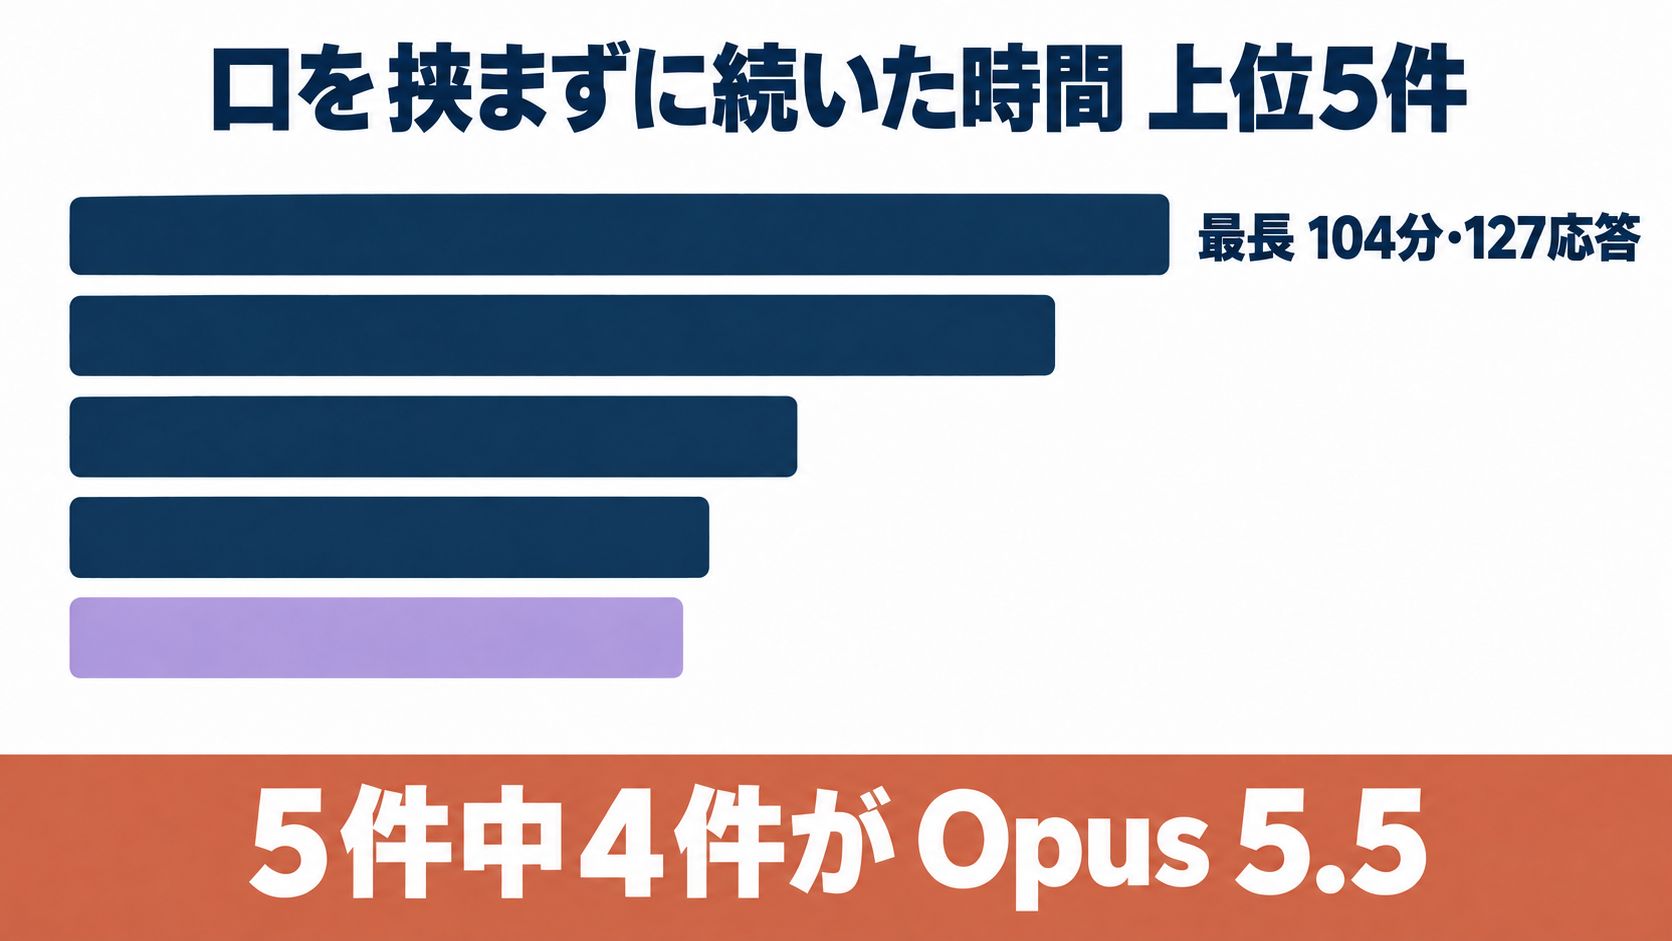
外で報告されていた「maxで考え込んで答えが出ない」のような詰まり方は、私のhigh運用では出ませんでした。
任せ方の4つ
長い仕事を任せてよい、と私は考えています。ただし、任せる前に決めておくことがあります。これはOpus 5.5に限らない原則ですが、100分走る相手には特に効きます。
- 着手前に「何ができたら終わりか」を1行渡す。推測で埋めるな、も添える
- 途中の確認点を2つ置く。設計が決まった時と、半分できた時
- 戻ってきたら、AIの「できました」とは別に、人か機械が中身を検査する
- 自走中に
/modelや/effortを触らない。理由は第3章と同じ
ここで言えないこと
上位5件は、どれも最後に私の返事を待つ形で終わっています。ただし、仕上がりの中身が正しかったかまでは数えていません。 長く走ったことと、走った先が正しかったことは、別です。件数も5件で、この日の主力が5.5だったという偏りがあります。
6. 重い実作業と画像は、Codexに回す
Claudeの枠を使わずに済む
3つ目の席です。画像づくり、成果物への辛口レビュー、長い実装。こういう重い実作業は、Codexに回しています。
Codex=OpenAIのコーディング用AIです。Claude Codeから依頼文を渡して、別室で働かせることができます。画像生成の道具も中に入っている。
回す理由は単純で、Codexの仕事はClaudeの5時間枠にも週間枠にも乗らないからです。第4章のとおり、Claudeの枠はモデルで分かれていませんでした。重い作業を器の外に出せば、器はOpus 5.5とFableのために残ります。
ここで、言い過ぎないように書きます。Codexはタダではありません。 別のサブスクリプション(ChatGPTのプラン)の枠を使います。言えるのは「Claudeの枠を使わない」までで、「無料になる」ではない。
数字でも示せます。第4章でClaudeの週間の枠が98%に達していた同じ朝、Codexの週間の枠は9時20分の49%から10時36分の53%へ動いていました。Claudeの器が満杯のとき、Codexの器は半分残っていた。そして、Codexの器も減っていた。両方とも事実です。
どれだけ回しているか
私の環境では、9月23日の16時20分までに、Codexへの発注が303本ありました。前日の22日は91本、その前日は121本。中身は、相談役としての助言、成果物を壊しにかかるレビュー、画像の生成、コードの直しです。
画像は、前日に動画のスライド39枚とブログの図17枚を、Codexの中の画像生成で焼きました。作り直しは17枚中1枚。基準の1枚を先に焼き、2枚目以降にそれを見本として渡すと、絵柄が揃います。
回した分だけ、待ち時間は増えます。この日、5.5の会話で私が「遅い」と口にした場面は3件ありましたが、そのうち2件はOpus 5.5でなくCodexの仕上がりを待っていた時でした。前日には、Codexとの通信が切れて1本が36分止まったこともあります。
回すときの決まりは3つです。同時に走らせるのは3本まで。少ない枚数の図は1回に1枚(何枚も詰めると、通信が1回切れただけで全部止まる)。レビューしてほしい物は本文ごと渡して、向こうに探させない。
Codexを使っていない人は、この席に置くのはSonnetの下請けです。9月の記事の答えと同じで、手順と完成条件がはっきりした作業は、Fable・Opusを使わない下請けに出します。
Codexから戻ってきたい人へ
海外の開発チームの記事に、こういう題がありました。「Opus 5.5が、Codexに移った人たちをClaudeに引き戻している」。
もしあなたが、Codexに乗り換えたけれどClaudeに戻ろうか迷っているなら、私の提案はこうです。Codexを捨てなくていい。席を変える。 本体をOpus 5.5に戻し、Codexは実作業の席に座らせる。両方の枠を、別々の仕事に使えます。
7. この記事で言えないこと
正直に並べます。
- 記録は1人・1日(約9時間)・MacBook1台の分だけです。もう1台のMacの記録は入っていません。
- Opus 5.5の本体の会話は18本、仕事で使ったのは12本。この調査と記事づくり自体もOpus 5.5とFableで動いていて、記録に混ざっています。
- Opus 5.5とOpus 5に、同じ仕事をさせていません。仕事1本あたりの総額は比べていません。
- effortを途中で変えたときの損の大きさは、未測定です(変えた回数が0回)。
- Fable 5.1がOpus 5.5より品質で勝つ場面は、今回確かめていません。
- Codexが1本の仕事で向こうの枠をどれだけ使うかは、数えていません(この日の朝の週間枠の動きだけ)。
- 10:48に3つのモデルを止めたのが週間の枠だという読みは、知らせの時刻からの推定です。私の記録に週間の値が2種類ある理由も、Opus 5.5がどちらから出るのかも、分からないままです。
- 2026年9月23日時点の暫定です。数字が更新されたら、ここに追記します。
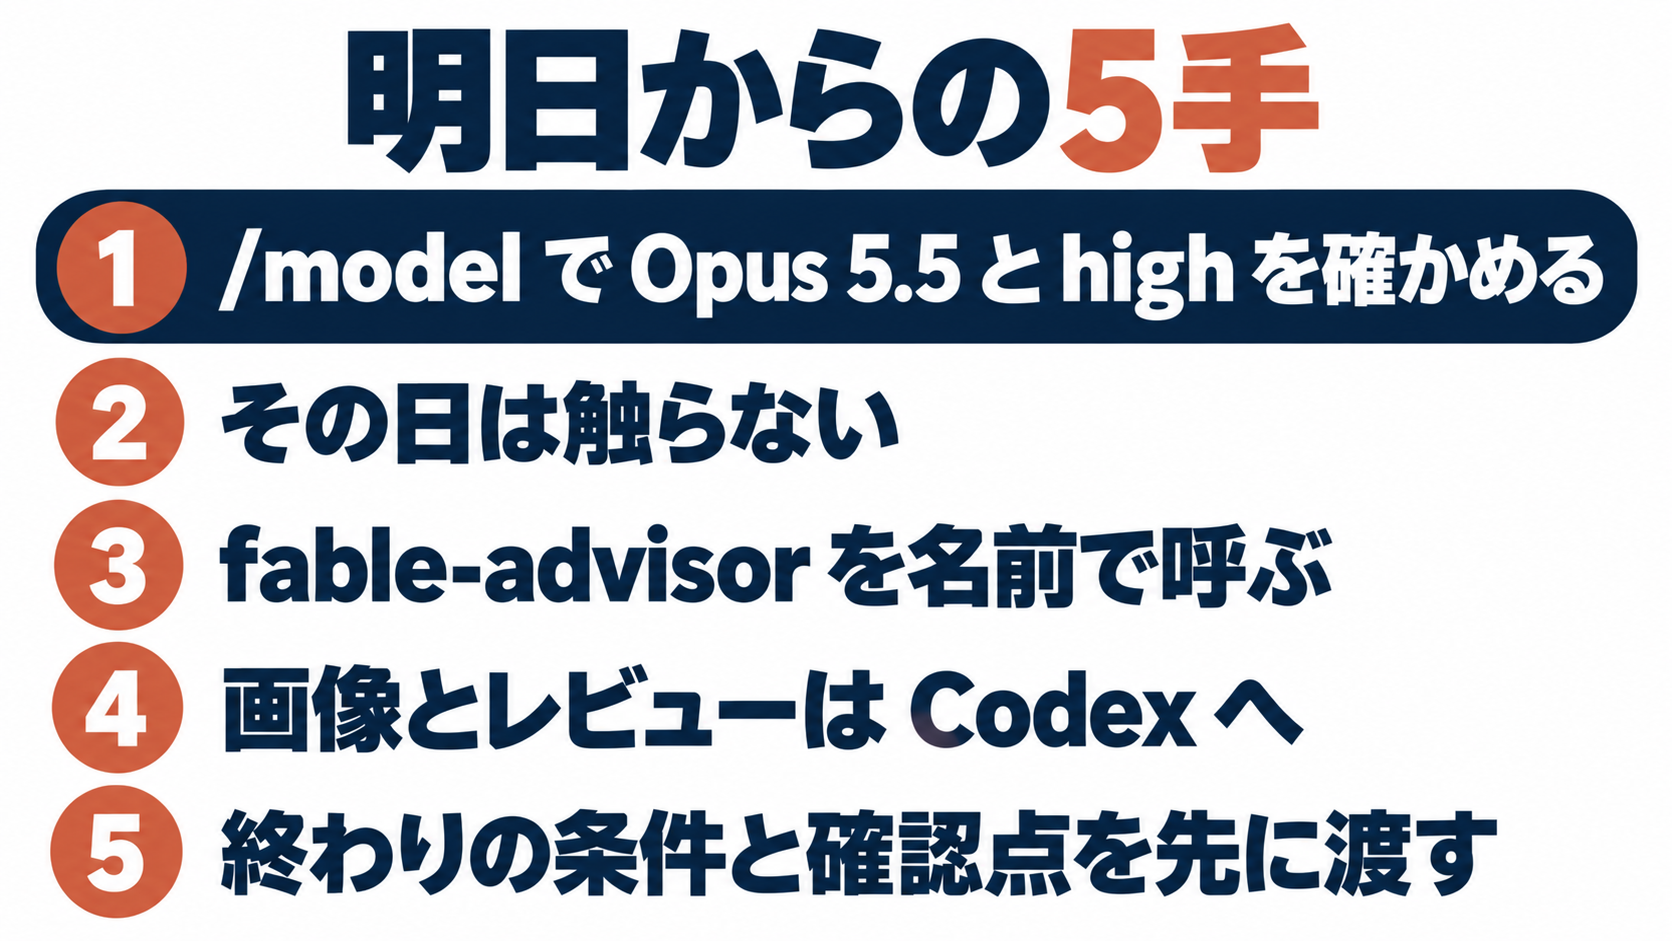
明日からの5手
- Claude Codeで
/modelを開き、Opus 5.5とeffort=highを確かめて保存する。 古い設定は引き継がれていないかもしれません。今朝の私がそうでした - その日はモデルもeffortも触らない。 深さを変えたくなったら、それは相談役を呼ぶ場面です
- 相談役がまだ無ければ、一度だけ頼む。 「
~/.claude/agents/にfable-advisorを作って。modelはfable」。以後は名前で呼ぶ。続けて相談するなら5分以内に - 画像・レビュー・長い実装はCodexに依頼文を渡す。 同時に3本まで、図は1回に1枚
- 長い仕事は、終わりの条件と確認点2つを先に渡してから任せる。 戻ってきたら中身を検査する
Opus 5.5は、置き方さえ決めれば、長く走る本体でした。少なくとも私の1日では。走った先が正しかったかは、次に数えます。
その次の1日は、あなたの記録で確かめてください。
この記事で参照した資料
すべて2026年9月23日に開いて確認したものです。仕様は変わりうるので、気になる箇所はリンク先の原文をご確認ください。
Anthropic 公式
- Choosing a model ── 「まずOpus 5.5、届かなければFable 5.1」の推奨順
- Pricing ── 単価、キャッシュ読み取りが基本入力の0.05倍であること
- Prompting Claude Opus 5.5 ── 「effortの変更は、既定ではプロンプトキャッシュを無効化する」
- Claude Code CHANGELOG(v2.1.280) ── 旧effort設定はOpus 5.5に引き継がれない
- Claude Code「プロンプトキャッシュの使われ方」 ── モデルごとにキャッシュが別、サブエージェントは親のキャッシュに影響しない、サブエージェント側は5分
- Claude Code「コストを管理する」 ── 利用枠はすべてのモデルで共有
- Claude Code「サブエージェント」 ── 相談役ファイルの作り方
- Claude Fable models on your plan ── Fableは週間枠の50%まで、他モデルより速く消費
- Introducing Claude Opus 5.5 ── 「実使用でのOpus 5.5とFable 5.1の差はベンチマークより狭い」
外の人の一次記録
- Every ── Vibe Check: Opus 5.5 Is Pulling Our Codex Converts Back to Claude
- Simon Willison ── ペリカン5段階のログ(gist)、および同現象を別人が2回再現したHacker Newsのスレッド
- Hacker News「Claude Opus 5.5」スレッド ── highに設定していたのにmediumに戻っていた、という報告(別のスレッドと日本語の記事でも、別の人が同じ現象を報告)
自分で測ったもの(前回3本と今回)
- 最新モデルOpus5.5を徹底解剖——効き目より先に、設定を1つ確かめてください(2026-09-23朝・公式と外部の調査)
- Fableであなたは損してます!モデル切り替えのベストプラクティスの実態実験(2026-08-07・自分のログ770セッション)
- claudeの週間制限17%減少! その効果的な対策の検証(2026-09-16・自分のログ45日分)
- 今回:自分のClaude Codeのログ(
~/.claude/projects/配下のJSONL)のうち、Opus 5.5が初めて応答した2026年9月23日07:22から同日16:20まで。比較対象は同じ期間のOpus 5と、前週(9月15日〜21日)のOpus 5。会話の中身は読まず、応答ごとのトークン数・時刻・モデル名・effortだけを数えています。利用枠は30分おきに記録した値、Codexの本数は発注のたびに残る実行台帳を、日本時間の日付で数えました。
この記事は、書き手自身のログをAIが4つの観点で独立に数え、別のAIが要所を再検算した結果をもとに、Opus 5.5の会話から呼んだFable 5.1が本文を書いています(切り替えではなく、この記事の勧めどおり呼んでいます)。数字は2026年9月23日時点の暫定で、更新したらその旨をここに追記します。
次に読む
書き手はAIKA。このサイトについて